Filtrer l’autocorrélation spatiale à partir d’un champ (Outils de statistiques spatiales)
Résumé
Crée une version spatialement filtrée d’un champ en entrée. La variable filtrée n’a pas d’agrégation spatiale statistiquement significative, mais préserve les propriétés statistiques principales du champ. La version spatialement filtrée du champ peut être utilisée dans des processus analytiques (tels que la corrélation ou l’analyse de régression) qui présument que les valeurs à chaque localisation sont spatialement indépendantes (non agrégées spatialement).
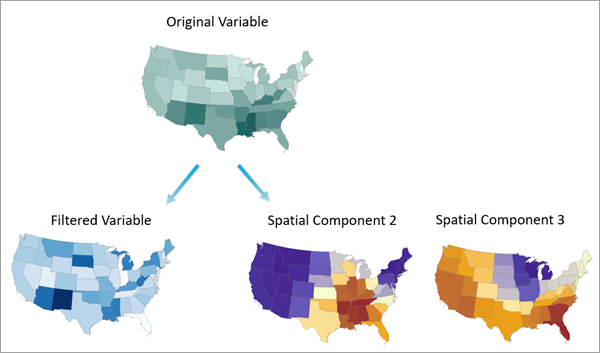
L’outil filtre l’autocorrélation spatiale en divisant le champ dans une composante non spatiale (le champ filtré) et un ensemble de composantes spatiales (vecteurs propres de Moran). Lorsque le champ en entrée est un champ de valeurs résiduelles ou de valeurs résiduelles standardisées provenant d’une prévision ou d’un modèle de régression, l’inclusion des composantes spatiales en tant que variables explicatives dans le modèle (en plus des variables explicatives d’origine) réduit ou élimine l’autocorrélation spatiale du terme résiduel, qui représente une hypothèse de divers modèles de prévision.
Illustration
Utilisation
La classe d’entités en sortie contient un champ de la variable en entrée filtrée spatialement ainsi que les champs des composantes spatiales utilisées pour la filtrer. Lorsqu’elle est exécutée dans une carte active, la couche d’entités en sortie s’affiche en fonction du champ en entrée filtré spatialement.
Les messages de géotraitement incluent les tables suivantes, qui récapitulent la sélection des composantes spatiales utilisées pour filtrer spatialement le champ en entrée :
Neighborhood Search History—Pour chacune des matrices de pondérations spatiales (SWM) testées, les informations détaillées de la matrice de pondérations spatiales (telles que le nombre de voisins et la structure de pondération), la valeur p de l’indice de Moran pour la variable en entrée d’origine, la valeur de l’indice de Moran et la valeur p de la variable en entrée filtrée spatialement, ainsi que le nombre de composantes requises pour supprimer l’autocorrélation spatiale, sont affichés. La matrice de pondérations spatiales sélectionnée pour filtrer le champ en entrée est indiquée en gras et signalée par un astérisque.
Spatial Component Search History—Pour la matrice de pondérations spatiales sélectionnée, la valeur de l’ID de chaque composante (par exemple, ID 4 désigne la quatrième composante spatiale), la valeur de l’indice de Moran de la composante, ainsi que la valeur de l’indice de Moran et la valeur p de la variable en entrée filtrée spatialement s’affichent. Les lignes sont classées dans l’ordre de sélection des composantes. Ainsi, la valeur p augmente à chaque ligne jusqu’à ce qu’elle dépasse 0,05 (valeur statistiquement non significative).
Afin de sélectionner la matrice de pondérations spatiales à utiliser pour filtrer l’autocorrélation à partir du champ en entrée, l’outil génère une liste de matrices de pondérations spatiales candidates et effectue des tests pour identifier celle qui supprime l’autocorrélation le plus efficacement. Si aucune matrice de pondérations spatiales n’est fournie dans le paramètre Input Spatial Weights Matrix Files (Fichiers de matrice de pondérations spatiales en entrée), 28 matrices de pondérations spatiales sont créées et incluses dans la liste des candidats (reportez-vous à la rubrique Comprendre les vecteurs propres de Moran pour une description de chaque matrice de pondérations spatiales). Si des matrices de pondérations spatiales en entrée sont fournies, vous pouvez utiliser le paramètre Compare Only Input Spatial Weight Matrices (Comparer uniquement les matrices de pondérations spatiales en entrée) pour indiquer si la liste des candidats inclut uniquement les matrices de pondérations spatiales fournies ou si elle inclut les matrices de pondérations spatiales fournies et les 28 matrices de pondérations spatiales créées par l’outil. Par exemple, pour utiliser une seule matrice de pondérations spatiales spécifiée, indiquez la matrice de pondérations spatiales dans le paramètre Input Spatial Weights Matrix Files (Fichiers de matrice de pondérations spatiales en entrée) et laissez le paramètre Compare Only Input Spatial Weight Matrices (Comparer uniquement les matrices de pondérations spatiales en entrée) coché.
L’outil sélectionne une matrice de pondérations spatiales parmi les candidats comme suit :
Un test est effectué sur le champ en entrée de chaque matrice de pondérations spatiales pour identifier toute autocorrélation spatiale statistiquement significative à l’aide du test de permutation de l’indice de Moran. Toute matrice de pondérations spatiales non statistiquement significative est retirée de la liste des candidats. Si l’autocorrélation spatiale n’est pas statistiquement significative (la valeur p est supérieure à 0,05) pour toutes les matrices de pondérations spatiales, l’outil échoue et le champ en entrée n’est pas filtré spatialement. Cela indique que le champ est non corrélé spatialement et ne doit pas, à ce titre, être filtré. Les valeurs p des tests sont ajustées à l’aide d’une correction Šidák afin de tenir compte du nombre de matrices de pondérations spatiales testées.
Pour chaque matrice de pondérations spatiales candidate restante, des composantes spatiales sont ajoutées de manière séquentielle et utilisées comme variables explicatives pour prévoir le champ en entrée. Pour chaque nouvelle composante spatiale, l’importante statistique de l’autocorrélation spatiale du terme résiduel est testée et chaque matrice de pondérations spatiales cesse d’ajouter des composantes dès que l’auto-corrélation des valeurs résiduelle n’est plus statistiquement significative (la valeur p est supérieure à 0,05). Chaque nouvelle composante est sélectionnée en fonction de la plus grande augmentation de la valeur p de l’autocorrélation du terme résiduel (ce qui indique la plus faible autocorrélation spatiale).
La matrice de pondérations spatiales qui a nécessité le moins de composantes pour produire les valeurs résiduelles non significativement auto-corrélées est retenue. Si des rattachements existent parmi le plus petit nombre de composantes, celui qui présente la plus grande valeur p est sélectionné.
Les composantes sélectionnées et les valeurs résiduelles sont renvoyées en tant que champs de la classe d’entités en sortie. Les valeurs résiduelles constituent la version spatialement filtrée du champ en entrée.
Cette procédure, appelée méthode de sélection MIR (Minimisation de l’autocorrélation résiduelle), est décrite en détail dans la référence suivante :
- Griffith, Daniel A., and Pedro R. Peres-Neto. 2006. "Spatial modeling in ecology: the flexibility of eigenfunction spatial analyses." Ecology 87, no. 10: 2603-2613. https://doi.org/10.1890/0012-9658(2006)87[2603:SMIETF]2.0.CO;2.
Paramètres
| Etiqueter | Explication | Type de données |
|---|---|---|
|
Input Features (Entités en entrée) |
Entités en entrée contenant le champ à filtrer spatialement. |
Feature Layer |
|
Champ en entrée |
Champ en entrée à filtrer spatialement. |
Field |
|
Entités en sortie |
Entités en sortie contenant un champ en entrée spatialement filtré et les champs des composantes spatiales utilisées pour le filtrage. |
Feature Class |
|
Append All Fields From Input Features (Ajouter tous les champs des entités en entrée) (Facultatif) |
Indique si tous les champs sont copiés des entités en entrée dans la classe d’entités en sortie.
|
Boolean |
|
Fichiers de matrice de pondérations spatiales en entrée (Facultatif) |
Liste des fichiers de matrice de pondérations spatiales en entrée ( |
File |
|
Fichier matrice de pondérations spatiales en sortie (Facultatif) |
Fichier SWM en sortie ( |
File |
|
Champ d’ID unique (Facultatif) |
Champ d’ID unique du fichier |
Field |
|
Comparer uniquement les matrices de pondérations spatiales en entrée (Facultatif) |
Indique si seuls les fichiers
|
Boolean |
Environnements
Transformations géographiques, Système de coordonnées en sortie, Facteur de traitement parallèle, Générateur de nombres aléatoires
Informations de licence
- Basic: Oui
- Standard: Oui
- Advanced: Oui
Rubriques connexes
- Vue d’ensemble du jeu d’outils Utilitaires des composantes spatiales (vecteurs propres de Moran)
- Comprendre les vecteurs propres de Moran
- Comparer les conceptualisations de voisinage
- Créer des variables explicatives des composantes spatiales
- Décomposer la structure spatiale (vecteurs propres de Moran)
- Rechercher un outil de géotraitement