通过数据去聚调整偏好采样
 需具备 Geostatistical Analyst 许可方可使用。
通常,数据的空间位置的间隔并不随机或固定。 出于各种原因,数据可能被有偏向采样,某些位置的样本点密度高于其他位置。 为了正确实施正态得分变换,样本的直方图(以及累积分布)正确反映整个总体的直方图非常重要。 如果对具有空间自相关性的数据进行有偏向采样,基于样本生成的直方图可能无法反映总体直方图。
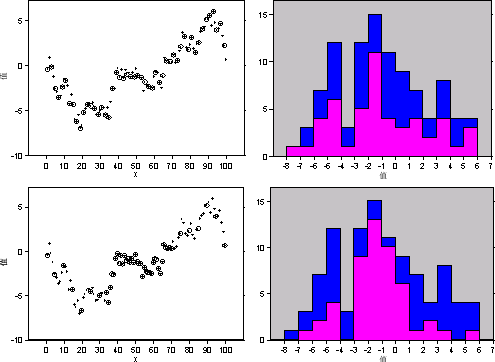
在去聚样本的左上图中,沿线 100 个位置的全体数值总体以实心圆表示。 这些数值是通过一个恒定均值且具有强正自相关性的空间自相关过程模拟出来的。 采样数据是从第一个点开始,每隔一点,并用圆圈表示。 在去聚样本的右侧,总体直方图用蓝色表示,样本直方图用紫色表示。
由于样本占总体的一半,预期样本直方图的条柱高度大约是总体的一半,且有一定的变异。 在左下角,数据被有偏向采样,每隔四个位置采样一次,直到位置 34,然后每个位置采样一次,直到位置 70,最后每隔四个位置采样一次,直到最后。 最终结果同样是对整个总体的一半进行采样。 朝向空间位置中间的偏向性采样导致样本中中间数据值的比例更高,因此对于介于 -3 到 1 之间的值,直方图条柱几乎等于总体条柱。 与此相应,样本直方图中较低和较高的值均未得到充分体现。
偏向性采样的一个解决方案是对数据加权,降低密集采样区域的数据权重(在上述有偏向性采样示例中,这会缩小介于 -3 至 1 之间的样本直方图条柱),而提高稀疏采样区域的数据权重(这会扩大较低和较高数据值的样本直方图条柱)。 Geostatistical Analyst 支持两种方法。 默认方法是像元去聚。 在像元去聚中,矩形像元在格网中的数据位置上排列,每个数据位置的相关权重与像元中的数据点数量成反比。
接下来就是选择格网大小和方向。 Geostatistical Analyst 提供了一张图表,用于显示不同像元大小下所有数据的加权平均值。 有人建议如果在高值区域对数据进行偏向性采样,则选择对应最小加权平均数的像元大小;反之,如果在低值区域对数据进行偏向性采样,则选择对应最大加权平均数的像元大小。
另一种方案使用面方法,定义围绕每个空间数据位置的面,使得该面内的所有位置比其他数据位置更接近该数据位置,如下图所示。
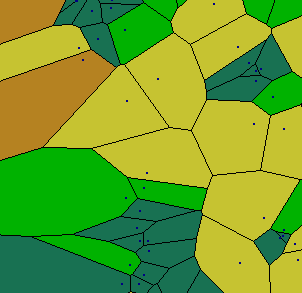
数据位置以小点表示,面围绕这些点绘制,彩色阴影表示面大小。 其理念是根据每个数据位置“代表”的面积对其进行加权。 这种方法的问题在于,难以定义靠近边缘的位置的权重。 除非数据被边界包围,否则边点的权重通常较大。 在 Geostatistical Analyst 中,边界是一个矩形,这通常会让边缘位置权重过大。