配置 ArcGIS Image Server 以进行深度学习栅格分析
ArcGIS Image Server 提供一套深度学习工具,用于分类和检测影像中的对象。 这些工具允许您生成训练样本数据集并将其导出至深度学习框架,以开发深度学习模型。 然后,您可以执行数据推断工作流,如影像分类和对象检测。
ArcGIS Image Server 提供一套工具来支持端到端的深度学习工作流。 您可以使用栅格数据来准备模型训练数据,训练深度学习模型以及使用推理工具(例如影像分类和对象检测)。
要在 ArcGIS Server 中启用深度学习功能,您需要满足两个要求:
设置深度学习库
要在栅格分析服务器中运行深度学习栅格分析,您需要安装深度学习库,因为栅格分析服务器利用第三方 Python 包来支持深度学习工作流。 安装并配置了栅格分析服务器后,请按照下面的部分安装深度学习库。
有关如何安装深度学习包的说明,请参阅 ArcGIS Image Server 的深度学习安装指南  。
如果您的栅格分析服务器站点上有多个节点,则需要在所有节点上执行上述步骤。
验证深度学习库安装
作为最后一步,您将通过上传深度学习包并在工具中选择它来查询 ArcGIS Living Atlas of the World 深度学习模型,以验证深度学习库是否正确安装。
在浏览器中,导航至 ArcGIS Living Atlas,然后下载建筑物覆盖区提取 - 美国。 深度学习包的文件扩展名为 .dlpk。
登录 Portal for ArcGIS。
导航至内容,然后单击新建项目。
将下载的深度学习包拖放到向导中。
点击保存更新深度学习包。
单击应用程序启动器,然后打开 Map Viewer。
在 Map Viewer 中,单击地图右侧设置工具栏上的分析按钮。
单击工具,选择使用深度学习,然后选择使用深度学习检测对象工具以展开工具参数。
在模型设置部分中,单击选择模型以选择工具的深度学习模型。
在选择项目对话框中,将打开我的内容文件夹,此处将提供您的所有深度学习包。
在“选择项目”对话框中,选择建筑物覆盖区提取 - 美国,然后单击确认。
如果成功加载了深度学习库,那么工具中的模型参数将出现在工具中。
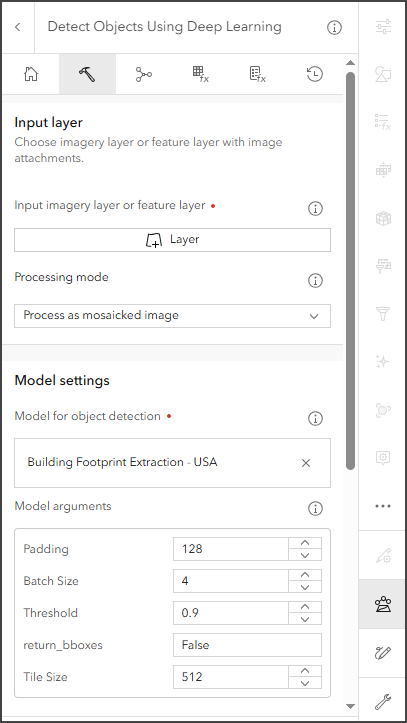
正确安装库后,深度学习包的模型参数将显示在工具中。
现在,您的栅格分析服务器已准备好执行深度学习分析。
使用 GPU 运行深度学习
深度学习栅格分析工作流中的每个工具都包括一个 processorType 环境参数,该参数控制处理是在 CPU 还是 GPU 上进行。 请确保此参数正确指定在发出请求时使用 CPU 还是 GPU。 可在 ArcGIS Pro、Map Viewer Classic、ArcGIS REST API 或 ArcGIS API for Python 的工具或栅格函数界面中设置 processorType 环境参数。
在栅格分析服务器中,推理工具可以使用 GPU 来加速作业处理。 关于 GPU 的要求如下所述:
先决条件:
GPU 类型:NVIDIA GPU,最低 CUDA 计算能力为 5.0;建议使用 6.1 或更高版本。
GPU 驱动程序:需要 527.41 或更高版本的 NVIDIA 驱动程序。
专用图形内存:
最低:6 GB
推荐:16 GB 或更高 内存要求取决于所使用的模型架构和批量大小。
满足所有 GPU 要求后,需要验证 RasterProcessingGPU 池。 RasterProcessingGPU 是负责运行推断工具的服务。
请按照以下步骤操作:
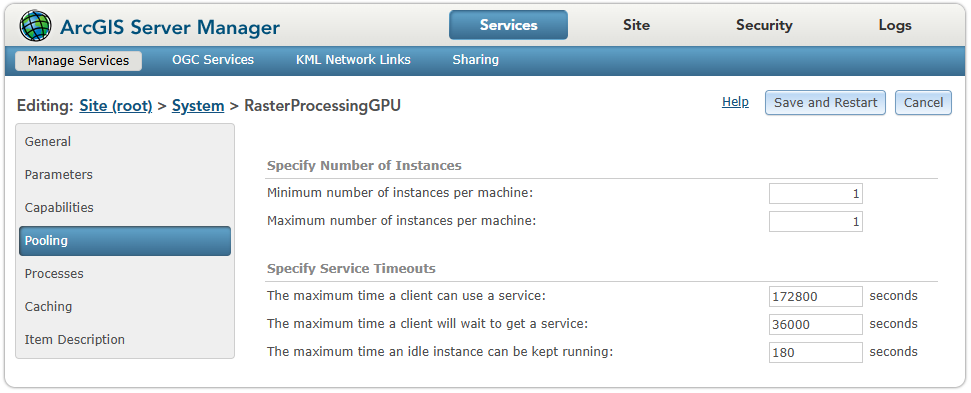
在浏览器中,导航至 ArcGIS Server Manager > 服务 > 系统 > RasterProcessingGPU > 管理服务 > 池化。
将每台计算机的最大实例数设置为计算机上的 GPU 数量。 如果您的计算机中只有一个 GPU,则将每台计算机的最大实例数设置为 1。 单击保存并重新启动。
在栅格分析服务器中使用多个 GPU
栅格分析服务器可利用多个 GPU 加速深度学习模型训练和推断。 GPU 使用率取决于操作系统和任务类型。
概述
ArcGIS Server (Linux):
支持单台计算机上进行多 GPU 训练。
支持每个节点一个 GPU 的多节点推断。
ArcGIS Server (Windows):
支持使用每个节点中的所有 GPU 进行多节点推断。
训练仅使用一个节点中的一个 GPU。
要求
确认是否满足 GPU 要求。
安装 ArcGIS GIS Server。
安装深度学习库。
将计算机连接到现有栅格分析服务器站点。
提示:
要获得稳定的服务器性能,站点中的所有 GPU 在每个节点中的类型和数量应相同。
推断
Windows:
将所有节点中的所有 GPU 用于推断。
示例:如果您具有 3 个节点,每个节点包含 4 个GPU → 共计 12 个 GPU。
Linux:
使用每个节点中的一个 GPU,但可以使用多个节点。
示例:如果您具有 3 个节点,每个节点包含 4 个GPU → 共计 3 个 GPU。
受支持的工具:
使用深度学习检测对象
使用深度学习分类像素
使用深度学习检测变化
配置步骤 (Windows):
打开 ArcGIS Server Manager → 服务 → 系统 → RasterProcessingGPU → 管理服务 → 池化。
将每台计算机的最大实例数设置为计算机上的 GPU 数量。
保存并重新启动。
配置步骤 (Linux):
- 保持每台计算机的最大实例数设置为 1。
在栅格分析服务器站点中启用多 GPU 功能后,可通过设置处理器类型和并行处理因子环境设置控制推断作业使用 GPU 的方式。 这有助于避免服务器资源过载。
训练
Windows:
- 训练仅使用一个节点中的一个 GPU。
Linux(从 12.1 版本开始):
对于 MaskRCNN 和 U-Net 模型,支持在单台计算机中进行多 GPU 训练。
使用一个节点中的所有 GPU。
示例:如果一个节点具有 4 个 GPU → 共计 4 个 GPU。
汇总表
| 操作系统 | 任务 | 所用节点 | 每个节点的 GPU 数 | 所用 GPU 总数 | 备注 |
|---|---|---|---|---|---|
| 窗口 | 推断 | 所有节点 | 所有 GPU | 站点中的所有 GPU | 多节点,多 GPU |
| 窗口 | 培训 | 1 | 1 | 1 | 仅单 GPU |
| Linux | 推断 | 所有节点 | 1 | 每个节点一个 GPU | 多节点,单 GPU |
| Linux | 培训 | 1 | 1 | 所有 GPU | 多 GPU(针对 MaskRCNN 和 U-Net) |