路径优先级配置
 需具备位置参考许可方可使用。
当两条或多条路线共享一段路面时,道路中将出现路线并发。 对于驾驶员来说,这可能是一种熟悉的场景,因为他们通常行驶的路线包括同时出现的路标,表明某段道路有多条路线。
由于事件引用部分而不是路线标识,因此并发路线会给 LRS Contributor 带来一些难题。 沿并发路线弧段的事件仅与一条路线关联,因此路线加载和路线编辑可能影响关联的事件。
如果停用或重新对齐一段并发路径,则该段上的现有事件记录可能分配到另一条并发路径(具体取决于分配至事件图层的事件行为)。 通过配置路径优先级规则,可以应用一组规则来确定在进行编辑后哪条路径将成为事件的新父路径。
可通过应用在弧段中确定主要路线的规则,应对让事件位于并发弧段中的主要路线上的需求。 优先级规则基于 LRS 事件表或要素类或者 LRS 网络中的字段,可对这些字段进行比较以对并发路线进行排序。
在 ArcGIS Roads and Highways 中,并发路径将共享相同的中心线要素,但是会使用属于路线的不同测量值进行建模。
有关配置路径优先级规则的详细信息,请参阅配置路径优先级规则工具文档。
路径优先级情景
以下情景演示了如何使用路径优先级规则来查找并发部分上的主要路径。
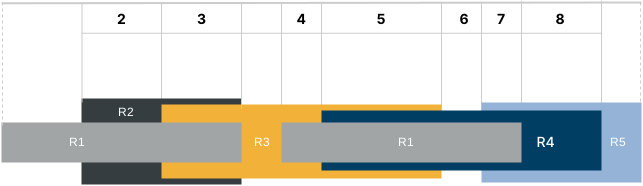
上图中显示了存在多个并发路段(2 到 8)的道路。 每个路径都有一个函数类和名称,而部分路径则有一个与之相关的编号。
下表识别了上述逻辑示意图中的并发弧段:
|
部分 |
并发路径 |
|---|---|
|
2 |
R1、R2 |
|
3 |
R1、R2、R3 |
|
4 |
R1、R3 |
|
5 |
R1、R3、R4 |
|
6 |
R1、R4 |
|
7 |
R1、R4、R5 |
|
8 |
R4、R5 |
下表显示了此情景中使用的函数类:
|
编码 |
功能等级 |
|---|---|
|
1 |
省际公路 |
|
3 |
主干道 |
|
6 |
地方道路 |
下表显示了路径编号、其函数类、路径 ID 的数字部分和路径名称:
|
路径 ID |
功能等级 |
数字 |
名称 |
|---|---|---|---|
|
R1 |
6 |
Stuart Ave |
|
|
R2 |
1 |
15 |
I15 |
|
R3 |
1 |
10 |
I10 |
|
R4 |
3 |
89 |
US89 |
|
R5 |
3 |
110 |
US110 |
注:
部分中的并发路径共享每个并发组中的 SectionId。
注册到网络的网络要素类或任何非跨线事件可用于计算并发。
异常可以用逗号分隔列出。
有多个属性字段可用于创建规则。
可以使用多个规则来确定优先级。
下面是应用规则的工作流:
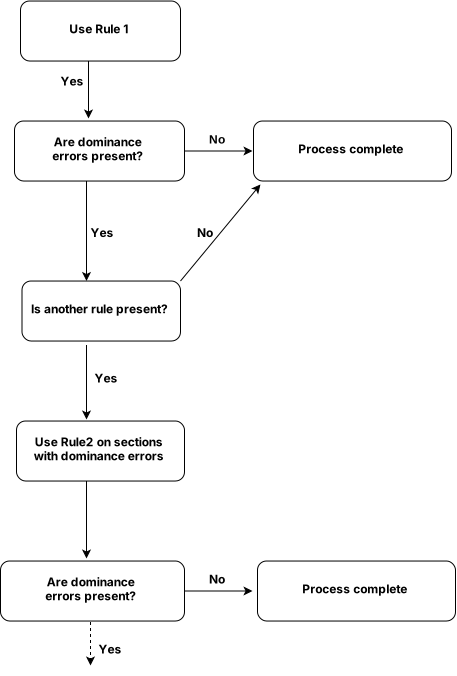
在此示例中,将使用两个规则来查找主要路径:
|
规则 |
字段 |
排序方法 |
排序类型 |
异常 |
|---|---|---|---|---|
|
Rule1 |
功能等级 |
较小 |
数值 |
|
|
Rule2 |
数字 |
较小 |
数值 |
110 |
并发部分中主要路径的主要标记值为 1;非主要路径的值为 0。 “主要错误”列具有以下五个可能值。
|
优先级错误 |
描述 |
|---|---|
|
0 |
计算并发弧段中的主要路线时无错误。 |
|
1 |
两条或多条路线具有相同的并发弧段属性值。 将随机选择主要路线。 |
|
2 |
用于计算并发弧段中的主要路线的一个或多个属性的值为 Null 或为空。 |
|
3 |
用于计算并发弧段中的主要路线的一个或多个属性的值过多。 |
|
4 |
并发弧段中出现以下情况之一:路线在并发弧段中未校准,或构成并发弧段的中心线未与路线几何对齐。 |
以下是使用上面提供的规则来计算路径优先级后的结果:
|
部分 ID |
RouteID |
优先级标记 |
优先级错误 |
详细信息 |
|---|---|---|---|---|
|
2 |
R1 |
0 |
0 |
|
|
2 |
R2 |
1 |
0 |
该路径的函数类值小于路径 R1 的函数类值,因此该路径为使用 Rule1 的主要路径。 |
|
3 |
R1 |
0 |
0 |
|
|
3 |
R2 |
0 |
0 |
|
|
3 |
R3 |
1 |
0 |
该路径的函数类值小于路径 R1 的函数类值,且与路径 R2 的函数类值相同。 由于使用 Rule1 时 R3 和 R2 之间存在平局,因此将使用 Rule2,其中 R3 的 |
|
4 |
R1 |
0 |
0 |
|
|
4 |
R3 |
1 |
0 |
该路径的函数类值小于路径 R1 的函数类值,因此该路径为使用 Rule1 的主要路径。 |
|
5 |
R1 |
0 |
0 |
|
|
5 |
R3 |
1 |
0 |
该路径的函数类值小于路径 R1 和 R4 的函数类值,因此该路径为使用 Rule1 的主要路径。 |
|
5 |
R4 |
0 |
0 |
|
|
6 |
R1 |
0 |
0 |
|
|
6 |
R4 |
1 |
0 |
该路径的函数类值小于路径 R1 的函数类值,因此该路径为使用 Rule1 的主要路径。 |
|
7 |
R1 |
0 |
0 |
|
|
7 |
R4 |
1 |
0 |
该路径的函数类值小于路径 R1 的函数类值,且与 R5 的函数类值相同。 由于使用规则 1 时 R3 和 R2 相等,因此将使用规则 2,其中 R4 的 |
|
7 |
R5 |
0 |
0 |
|
|
8 |
R4 |
0 |
0 |
|
|
8 |
R5 |
1 |
0 |
该路径的函数类值与 R4 的函数类值相同。 由于使用规则 1 时 R4 和 R5 相等,因此将使用规则 2,其中 110 将作为异常列出,从而使 R5 成为主要路径。 |
注:
或者,可以使用多个字段来创建规则:
|
规则 |
字段 |
排序方法 |
排序类型 |
异常 |
|---|---|---|---|---|
|
Rule1 |
函数类,编号 |
较小 |
数值 |
US110 |
在这种情况下,两个字段(按照它们在列表中显示的顺序)的串联值将用于计算优先级。