ToolValidator 类
有关 ToolValidator 类的概述和参数方法的使用,请参阅自定义脚本工具行为。
参数对象
下面提供了有关 Parameter 对象的信息。
访问工具参数
每个工具参数都拥有一个包含可用于工具验证的属性和方法的关联参数对象。 参数包含在列表中。 标准做法是在工具类的 ToolValidator 类 __init__ 方法中创建参数列表,如以下代码所示。
def __init__(self):
 self.params = arcpy.GetParameterInfo()
还可访问脚本(而不是 ToolValidator 类)中的参数,如下所示。 仅当设置 symbology 属性时,才会访问脚本中的参数列表。
params = arcpy.GetParameterInfo()
参数顺序
工具参数及其顺序在工具属性的参数选项卡中定义,如下图所示。
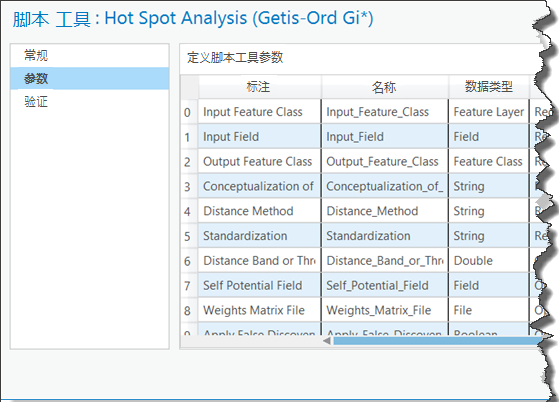
注:
参数列表从零开始排序,因此第一个参数位于列表中的零位置上。 要访问第三个参数,应输入 p3 = self.params[2]。
方法
下表中介绍了 Parameter 对象方法:
|
方法名称 |
用法描述 |
|---|---|
|
|
通过提供的消息将参数标记为存在错误( |
|
|
通过提供的消息将参数标记为存在警告( |
|
|
用于设置系统消息。 参数与 |
|
|
清除所有消息文本并将状态设置为信息性状态(无错误或警告)。 |
|
|
如果参数包含错误,则返回 true。 |
|
|
如果参数包含警告,则返回 true。 |
|
|
如果在模型内部验证工具并且输入值是模型中其他工具的输出,则返回 true。 |
 )。 如果其中任何参数存在错误,则不会运行工具。
 )。 与存在错误时不同,工具在有警告消息的情况下也会运行。
属性
下表中介绍了 Parameter 对象属性:
|
属性名称 |
读/写 |
值 |
描述 |
|---|---|---|---|
|
|
只读 |
字符串 |
工具属性的参数选项卡上定义的参数名称。 |
|
|
只读 |
字符串
|
工具属性的参数选项卡上定义的参数输入或输出方向。 |
|
|
只读 |
字符串 |
工具属性的参数选项卡上定义的数据类型。 |
|
只读 |
字符串
|
工具属性的参数选项卡上定义的参数类型。 |
|
|
读/写 |
列表 |
各依存参数的索引列表。 |
|
|
读/写 |
|
参数值。 |
|
|
|
只读 |
字符串 |
工具属性的参数选项卡上定义的默认环境设置。 |
|
|
读/写 |
布尔 |
指定参数是否无效。 |
|
只读 |
布尔 |
指定是否已修改该值。 |
|
|
只读 |
布尔 |
指定内部验证例程是否检查了参数。 |
|
|
|
只读 |
字符串 |
参数类别。 |
|
只读 |
|
输出数据集方案。 |
|
|
读/写 |
|
要应用于参数值的过滤器。 |
|
|
|
读/写 |
|
应用于值表参数中的列或复合参数中的多种数据类型的过滤器。 有关详细信息,请参阅 |
|
读/写 |
字符串 |
用于绘制输出的图层文件 ( |
|
|
|
只读 |
字符串 |
要向用户显示的消息。 请参阅上述 |
虽然很多 Parameter 对象属性为读/写,但其中大多数属性只能在最初创建或修改对象时进行设置或修改。 以下属性建立了参数的特征,并且在验证方法(例如 updateMessages 和 updateParameters)执行期间不能修改:
categorycontrolCLSIDdatatypedirectiondisplayNamedisplayOrdermultiValuenameparameterDependenciesparameterType
下面显示了一些代码示例。 有关其他代码示例,请参阅自定义脚本工具行为。
ToolValidator 属性与脚本工具属性
可在脚本工具的属性对话框的参数选项卡上或在 ToolValidator 类中设置参数的默认值、过滤器、符号系统和依赖关系。
在 ToolValidator 类中设置的属性将覆盖在脚本工具属性对话框中设置的属性,并且通常会提供额外的自定义选项。 例如,如果在脚本工具属性对话框中将参数的默认值设置为 "BLUE",然后在 initializeParameters 中将其重置为 "RED",则默认值会变为 "RED"。 调用 initializeParameters 后,脚本工具属性对话框会将 "RED" 显示为默认值。 如果您(或您的用户)遇到未保存在脚本的属性对话框中对这四个参数属性中某一个所作更改的情况,则可能是因为属性在 ToolValidator 类内被覆盖。
parameterDependencies
通常,需要设置参数相关性以供 Schema 对象使用。 在下面的两种情况中,相关性可能已在工具属性对话框的参数选项卡上进行设置。
对于具有派生类型的输出数据集参数,相关性为派生输出的参数的索引。
对于特定的输入数据类型,依赖项为含有控件所用信息的参数的索引,如下表所示。
|
参数数据类型 |
依赖参数数据类型 |
|---|---|
|
面积单位 |
用于确定默认单位的地理数据集。 例如,可以使用要素图层、栅格图层、要素集或记录集数据类型。 |
|
字段 |
含有字段的表。 例如,可以使用表视图、要素图层、栅格图层、要素集或记录集数据类型。 |
|
字段映射 |
一个或多个输入表中的字段集合。 例如,可以使用表视图、要素图层、栅格图层、要素集或记录集数据类型。 |
|
地统计值表 |
在 Geostatistical Analyst 工具中使用的数据集和字段的表。 使用地理统计图层数据类型。 |
|
线性单位 |
用于确定默认单位的地理数据集。 例如,可以使用要素图层、栅格图层、要素集或记录集数据类型。 |
|
Network Analyst 等级设置 |
包含等级信息的网络数据集。 使用网络数据集数据类型。 |
|
网络出行模式 |
出行模式列表。 使用网络数据源、网络数据集或网络数据集图层数据类型。 |
|
SQL 表达式 |
含有字段的表。 例如,可以使用表视图、要素图层、栅格图层、要素集或记录集数据类型。 |
依赖项通常在 initializeParameters 方法中进行设置:
def initializeParameters(self):
 # Set the dependencies for the output and its schema properties
 self.params[2].parameterDependencies = [0, 1]
parameterType
parameterType 属性可以是必需、可选或派生。
必需 - 需要值才能运行工具。
可选 - 无需值即可运行工具。
派生 - 未作为输入参数提供的输出值。 派生参数始终为输出参数。
在验证中,无法动态修改 parameterType 值。 但是,根据其他参数设置,参数可能需要充当必需参数或可选参数。 如果是这样,将参数设置为可选。 然后,在验证 updateMessages 方法中,将 Parameter setIDMessage 方法与消息 ID 530 或 735 搭配使用。 使用消息 ID 530 或 735 时将导致可选参数的行为与必需参数相同。
# Make a parameter required using setIDMessage if the preceding
# parameter does not have a value.
if not self.params[4].valueAsText:
 self.params[5].setIDMessage('ERROR', 735)
value
这是由用户输入的或者通过编程方式设置的参数值。 可以在 initializeParameters 中设置值,此时它用作参数的初始默认值。 还可在 updateParameters 中设置值以响应用户输入,如下所示。
def updateParameters(self):
 # Set the default distance threshold to 1/100 of the larger of the width
 #  or height of the extent of the input features.  Do not set if there is no
 #  input dataset yet, or the user has set a specific distance (altered is true).
 if self.params[0].valueAsText:
     if not self.params[6].altered:
         extent = arcpy.Describe(self.params[0]).extent
     if extent.width > extent.height:
         self.params[6].value = extent.width / 100
     else:
         self.params[6].value = extent.height / 100
 return
参数的 value 属性会返回一个对象,除非未填充参数,这种情况下 value 将返回 None。 要确保已填充参数,在使用其值之前使用 if 检查。
下面的代码片段用于测试值是否等于字符串 "Get Spatial Weights From File"。 该测试能够顺利进行是因为参数数据类型是字符串。
# If the option to use a weights file is selected, enable the
#   parameter for specifying the file, otherwise disable it
if self.params[3].value:  # check that the parameter has a value
 if self.params[3].value == "Get Spatial Weights From File":
     self.params[8].enabled = True
 else:
     self.params[8].enabled = False
由于 Value 对象不支持字符串操作,每当操作或解析字符串时都使用 Value 对象的 value 属性。 下面代码示例使用 os.path.dirname 方法从数据集返回目录。
if self.params[0].value:
 workspace = os.path.dirname(self.params[0].value.value)
注意:
不要使用在验证中采用目录路径(例如 ListFields)的方法,Describe 例外。 在 ModelBuilder 中验证工具时数据集可能并不存在,因此方法可能会失败或产生意外结果。
Describe 可直接用于 Parameter 对象,而不使用参数的 value 属性。 使用 value 属性是有效的,但在处理图层输入时速度较慢。
对于 ListFields 这种特殊情况,Describe 对象的 fields 属性将提供等效信息。
注意:
请不要在 updateMessages 中设置参数值,否则内部验证例程将不会验证该值。
altered
如果参数值被更改(例如通过输入输出路径进行更改),则 altered 属性为 true。 参数更改之后,它会保持更改状态直到用户将该值清空(移除),这时它就恢复到未更改状态。 通过验证代码以编程方式更改值将会改变 altered 的状态。 也就是说,如果为参数设置了值,参数的 altered 状态将会更新。
altered 属性用于指定是否可以更改某个参数的值。
例如,工具拥有要素类参数和关键字参数。 如果要素类包含点或面,则关键字为 RED、GREEN 和 BLUE,如果包含线,则关键字为 ORANGE、YELLOW、PURPLE 和 WHITE。
然后用户输入了一个点要素类。 如果关键字参数处于未更改状态,则将值设置为 RED,因为它是默认值。
如果输入了线要素类,则将默认值设置为 ORANGE(只要关键字参数处于未更改状态)。
不过,如果用户已更改关键字参数(即,将关键字设置为 GREEN),则不应重置关键字。 用户已做出选择 (GREEN),但您还不知道他们的意图。 他们可能更改要素类,以使 GREEN 有效,或者可能更改关键字(例如,改为 PURPLE)。 由于 GREEN 不是一种为线创建的关键字设置,所以内部验证将参数标记为错误。 此时,用户有两种选择:更改输入要素类或者更改关键字。
if not self.params[2].altered:
 self.params[2].value = "POINT"
hasBeenValidated
如果在最后一次调用 updateParameters 和内部验证之后用户修改了参数值,则 hasBeenValidated 属性为 false。 调用内部验证后,地理处理会自动为每个参数将 hasBeenValidated 设置为 true。
hasBeenValidated 属性用于指定自上次调用 updateParameters 后用户是否对值进行了更改。 可以使用此信息决定是否自行检查参数。
# Set the default distance threshold to 1/100 of the larger of the width
#  or height of the extent of the input features. Do not set if there is no
#  input dataset yet, or if the input features have already been validated,
#  or the user has set a specific distance (Altered is true).
if self.params[0].valueAsText and not self.params[0].hasBeenValidated:
 if not self.params[6].altered:
     extent = arcpy.Describe(self.params[0]).extent
     width = extent.width
     height = extent.height
     if width > height:
         self.params[6].value = width / 100
     else:
         self.params[6].value = height / 100
symbology
symbology 属性用于将图层文件 (.lyrx) 与输出参数关联在一起。
params[2].symbology = "E:/tools/extraction/ToolData/ClassByDist.lyrx"
schema 对象
类型为要素类、表、栅格或工作空间的每个输出参数都具有 schema 对象。 只有输出要素类、表、栅格和工作空间具有 schema;其他类型则没有。 schema 对象是通过地理处理自动创建的。 可以通过参数对象访问此 schema,或者设置规则以描述工具的输出。 在设置方案规则并从 ToolValidator 类获得返回值之后,地理处理内部验证代码会检查设置的规则并更新输出的描述。
回顾一下,控制流程如下:
第一次在地理处理窗格中打开该工具时,将调用
initializeParameters。 设置静态规则(不会因用户输入而发生改变的规则)以描述输出。 此时不会创建任何输出描述,因为用户尚未指定任何参数的值(除非已提供默认值)。在用户与地理处理窗格中的工具进行交互后,将调用
updateParameters。updateParameters可以将 schema 对象修改为考虑无法通过参数相关性确定的动态行为(例如添加“添加字段”等新字段)。从
updateParameters获得返回值后,会调用内部验证例程并通过应用 schema 对象中的规则来更新输出数据的描述。调用
updateMessages。 您可以检查内部验证可能已创建的警告消息和错误消息,然后修改它们或者添加自定义警告消息和错误消息。
除 type 为只读之外,其他所有 schema 属性均可读写。
下表中列出了 Schema 对象属性值:
|
属性名称 |
值 |
|---|---|
|
|
字符串: |
|
|
布尔 |
|
|
字符串: |
|
|
字符串: |
|
|
字符串: |
|
|
字符串: |
|
|
字符串: |
|
|
|
|
|
字符串: |
|
|
|
|
|
字符串: |
|
|
双精度 |
|
|
字符串: |
|
|
字符串: |
|
|
要添加到工作空间方案的数据集列表 |
使用 FirstDependency
许多规则都可设置为 "FirstDependency",这表示在参数相关性数组集中找到的第一个参数的值将与 parameter.parameterDependencies 一起使用。 在以下代码示例中,参数 2 具有两个依存参数:参数 0 和参数 1,第一个依赖项是参数 0。
# Set the dependencies for the output and its schema properties
self.params[2].parameterDependencies = [0, 1]
如果任一依存参数为多值(值列表),则会使用多值列表中的第一个值。
type
type 属性是只读的,并通过地理处理进行设置。
clone
如果为 true,则地理处理过程将精确复制(克隆)第一个相关参数中的描述。 默认值为 false。 通常,在 initializeParameters 方法中将 clone 设置为 true。 如果第一个依存参数为多值(值列表),则会克隆多值列表中的第一个值。
如果
parameter.parameterType为"Derived",则会进行精确复制。 这是添加字段工具的行为。如果
parameter.parameterType为"Required",仍会进行精确复制,但是会更改数据集的目录路径。 目录路径包括两部分:工作空间和基本名称,例如E:/Data/TestData/netcity.gdb/infrastructure/roads,并且包含以下解释:工作空间 =
E:/Data/TestData/netcity.gdb/infrastructure基本名称 =
roads
用于构造新输出名称的规则如下:
基本名称与含有数据集的第一个输入参数(不是第一个依赖项而是第一个参数)的基本名称相同,还会附加脚本工具名称(例如,
roads_MyTool)。将工作空间设置为临时工作空间环境设置。 如果未设置临时工作空间环境,则使用当前工作空间环境设置。 如果当前工作空间环境也未设置,则使用包含数据集的第一个输入参数的工作空间。 如果该工作空间为只读,则将使用系统临时目录。
将 clone 设置为 true 后,所有基于规则的方法(例如 featureTypeRule、geometryTypeRule 和 extentRule)均设置为 "FirstDependency"。
下面的两个代码示例有着相同作用。 两个示例均基于使用裁剪工具创建输出方案的过程。
示例 1:显式设置所有规则
def initializeParameters(self):
 # Set the dependencies for the output and its schema properties
 #  The two input parameters are feature classes.
 self.params[2].parameterDependencies = [0, 1]
 # Feature type, geometry type, and fields all come from the first
 #  dependency (parameter 0), the input features
 self.params[2].schema.featureTypeRule = "FirstDependency"
 self.params[2].schema.geometryTypeRule = "FirstDependency"
 self.params[2].schema.fieldsRule = "FirstDependency"
 # The extent of the output is the intersection of the input features
 #  and the clip features (parameter 1)
 self.params[2].schema.extentRule = "Intersection"
 return
示例 2:使用 clone 将规则设置为 FirstDependency;然后覆盖范围规则
def initializeParameters(self):
 # Set the dependencies for the output and its schema properties
 #  The two input parameters are feature classes.
 self.params[2].parameterDependencies = [0, 1]
 self.params[2].schema.clone = True
 return
def updateParameters(self):
 # The only property of the clone that changes is that the extent
 #  of the output is the intersection of the input features
 #  and the clip features (parameter 1)
 self.params[2].schema.extentRule = "Intersection"
 return
featureTypeRule
该设置用于确定输出要素类的要素类型。 此规则对输出栅格或输出表不起作用。
下表将介绍这些 featureTypeRule 值:
|
值 |
描述 |
|---|---|
|
|
要素类型将通过 |
|
|
要素类型将与依赖项中的第一个参数相同。 如果第一个依存参数为多值(值列表),则将使用多值列表中的第一个值。 |
featureType
当 featureTypeRule 为 "AsSpecified" 时,featureType 的值用于指定输出的要素类型。
下表将介绍这些 featureType 值:
|
值 |
描述 |
|---|---|
|
|
输出将包含简单要素。 要素的几何类型由 |
|
|
输出将包含注记要素。 |
|
|
输出将包含尺寸要素。 |
geometryTypeRule
该设置用于确定输出要素类的几何类型(例如点或面)。
下表将介绍这些 geometryTypeRule 值:
|
值 |
描述 |
|---|---|
|
|
这是默认设置。 通常,应该能够根据其他参数值确定 |
|
|
几何类型与第一个依存参数相同。 如果第一个依存参数为多值(值列表),则会使用多值列表中的第一个值。 |
|
|
将检查所有相关参数的几何并且输出几何类型设置为找到的最小或最大类型。
所以,如果相关参数是点和面要素类,则最小类型将为点,最大类型将为面。 |
|
|
几何类型将通过 |
geometryType
将此项设置为当 geometryTypeRule 为 "AsSpecified" 时要使用的几何类型("Point"、"Multipoint"、"Polyline" 或 "Polygon")。
extentRule
下表将介绍这些 extentRule 值:
|
值 |
描述 |
|---|---|
|
|
输出范围将在 |
|
|
输出范围与第一个依存参数相同。 如果第一个依存参数为多值(值列表),则会使用多值列表中的第一个值。 |
|
|
输出范围将是所有依存参数的几何交集。 (这是裁剪工具使用的输出范围,如下所示。) |
|
|
输出范围将是所有依存参数的几何并集。 |
|
|
输出范围将基于范围环境设置进行计算。 |
示例
# The extent of the output is the intersection of the input features
#  and the clip features (the dependent parameters)
self.params[2].schema.extentRule = "Intersection"
extent
将此项设置为当 extentRule 为 "AsSpecified" 时要使用的范围。 可使用以空格分隔字符串或者含有四个值的列表设置范围。 顺序为 xmin、ymin、xmax、ymax。
示例
self.params[2].schema.extentRule = "AsSpecified"
self.params[2].schema.extent = "123.32 435.8 987.3 567.9"
# Alternatively use a list, as follows:
# self.params[2].schema.extent = [123.32, 435.8, 987.3, 567.9]
fieldsRule
fieldsRule 属性确定将在输出要素类或输出表上存在的字段。
在下表中,FID 代表“要素 ID”,但实际上指每个要素类或表中的 ObjectID 字段。
|
值 |
描述 |
|---|---|
|
|
不会输出任何字段,ObjectID 除外。 |
|
|
输出字段将与第一个依存参数相同。 如果第一个依存参数为多值(值列表),则将使用多值列表中的第一个值。 |
|
|
只有第一个依存输入的 ObjectID 会写入到输出中。 |
|
|
将输出依存参数列表中的所有字段。 |
|
|
除 ObjectID 字段以外的所有字段都将写入输出中。 |
|
|
所有 ObjectID 字段都将写入输出中,但是输入中的其他字段不会写入。 |
以下是使用 "FirstDependency" 值 fieldsRule 的裁剪工具的示例:
def initializeParameters(self):
 # Set the dependencies for the output and its schema properties
 #  The two input parameters are feature classes.
 self.params[2].parameterDependencies = [0, 1]
 # Feature type, geometry type, and fields all come from the first
 #  dependency (parameter 0), the input features
 self.params[2].schema.featureTypeRule = "FirstDependency"
 self.params[2].schema.geometryTypeRule = "FirstDependency"
 self.params[2].schema.fieldsRule = "FirstDependency"
 # The extent of the output is the intersection of the input features
 #  and the clip features (parameter 1)
 self.params[2].schema.extentRule = "Intersection"
 return
additionalFields
除了通过应用 fieldsRule 添加的字段以外,还可向输出添加更多字段。 additionalFields 属性将采用字段对象列表。
cellSizeRule
cellSizeRule 属性决定了输出栅格或输出格网的像元大小。 下表将介绍其值:
|
值 |
描述 |
|---|---|
|
|
输出像元大小在 |
|
|
像元大小由第一个依存参数进行计算。 如果相关参数是栅格,则将使用其像元大小。 对于其他类型的依存参数,例如要素类或要素数据集,数据范围用于计算像元大小。 如果第一个依存参数为多值(值列表),则会使用多值列表中的第一个值。 |
|
|
|
|
|
输出像元大小基于像元大小环境设置进行计算。 |
cellSize
将 cellSize 属性设置为当 cellSizeRule 为 "AsSpecified" 时要使用的像元大小。
rasterRule
rasterRule 属性确定输出栅格中包含的数据类型(整型或浮点型)。 下表将介绍其值:
|
值 |
描述 |
|---|---|
|
|
数据类型(整型或浮点型)与第一个依存参数相同。 如果第一个依存参数为多值(值列表),则会使用多值列表中的第一个值。 |
|
|
整数被视为小于浮点数。 例如,如果有两个依存参数,一个包含整数,另一个包含浮点数,则 |
|
|
输出栅格包含整型数(整数)。 |
|
|
输出栅格包含浮点数(小数)。 |
rasterFormatRule
rasterFormatRule 属性指定输出栅格格式,"Grid" 或 "Img"。 默认值为 "Img",它是 ERDAS IMAGINE 格式。 "Grid" 为 Esri 格式。
additionalChildren
工作空间是保存数据集(要素、表和栅格)的容器。 这些数据集相当于工作空间的子辈(如果将工作空间看作父辈的话)。 如果工具将数据集添加到新的或者现有的工作空间中,那么可通过添加对子辈的描述来更新工作空间的描述。 例如,工具采用要素类列表(多值),以某种方式进行修改,然后将修改后的要素类写入现有工作空间。 在模型构建器中使用此工具时,工作空间就是派生的工具输出,可以将该工作空间用作选择数据工具的输入。 通过选择数据工具可以从容器中选择某个子数据集,并将它用作其他工具的输入。
additionalChildren 的输入是对子辈的一个或多个描述。 下表介绍了子项描述的两种形式:
|
表单 |
描述 |
|---|---|
|
|
|
|
|
含有要添加的子辈描述的列表。 列表中只有前两个条目 |
添加多个子项时,提供子项描述列表。 如果以列表形式添加子项,为 additionalChildren 创建一系列列表。
列表形式使用如下表中所述的参数:
|
参数 |
类型 |
描述 |
|---|---|---|
|
|
必填 |
下列类型之一: |
|
|
必填 |
数据集的名称。 可以是数据集的基本名称(例如 |
|
|
可选 |
字段对象列表。 这包含子辈中出现的字段(如果已知)。 |
|
|
可选 |
包含子辈空间范围的字符串或列表。 |
|
|
可选 |
空间参考对象。 |
这些参数必须按照下列顺序提供。 要跳过可选参数,使用 None 或 '#'。
下面是设置工作空间方案的示例。 这些示例基于具有下列参数的脚本工具:
|
参数索引 |
参数名称 |
属性 |
|---|---|---|
|
0 |
输入要素类 |
要素类 - 输入。 |
|
1 |
输入表 |
表 - 输入。 |
|
2 |
输入工作空间 |
工作空间 - 输入(包含工具结果的现有工作空间)。 |
|
3 |
派生工作空间 |
工作空间 - 派生输出,获取自输入工作空间。 该工作空间的方案经修改可包含其他子辈。 |
此工具将获取输入要素类和表,将二者复制到工作空间,向要素类添加新字段,然后在工作空间中创建面要素类。 (此工具的实际作用并不是很重要,因为它仅仅是用于举例说明工作空间方案的设置。)这些代码示例彼此关联,从 additionalChildren 的简单用法开始。
在 initializeParameters 中,输出工作空间通过其依存参数(参数 2)克隆。 此相关性不仅在工具属性中进行设置,还可在 initializeParameters 中进行设置,以防用户移除工具属性中的相关性。
class ToolValidator:
 def __init__(self):
     self.params = arcpy.GetParameterInfo()
 def initializeParameters(self):
     self.params[3].parameterDependencies = [2]  # input workspace
     self.params[3].schema.clone = True  # Copy all existing contents to output
     return
示例:将两个输入(未修改)复制到输出工作空间
def updateParameters(self):
 inFC = self.params[0].value  # input feature class
 inTable = self.params[1].value  # input table
 inWS = self.params[2].value  # input workspace
 if inFC and inTable and inWS:
     self.params[3].schema.additionalChildren = [inFC, inTable]
 return
示例:此工具将创建面要素类
与该新要素类有关的已知属性(验证时)仅有名称 "SummaryPolygon" 和类型 "polygon"。
children = []  # New empty list
children.append(inFC)
children.append(inTable)
children.append(["polygon", "SummaryPolygon"])
self.params[3].schema.additionalChildren = children
示例:向输入要素类添加字段
# Create a field object with the name "Category" and type "Long".
newField = arcpy.Field()
newField.name = "Category"
newField.type = "Long"
# Describe the input feature class to get its list of fields. The 9.3
# version of the geoprocessing object returns fields in a list, unlike previous
# versions, which returned fields in an enumerator.
desc = arcpy.Describe(inFC)
fieldList = desc.fields
# Add the new field to the list.
fieldList.append(newField)
# Create a new child based on the input feature class but with the
# additional field added.
newChild = [desc.shapeType, desc.catalogPath, fieldList,
         desc.extent, desc.spatialReference]
# Now create the list of children and add to the schema.
children = []
children.append(newChild)
children.append(inTable)
children.append(["polygon", "SummaryPolygon"])
self.params[3].schema.additionalChildren = children
要为 SummaryPolygon(新的面要素类)创建字段,请创建与上面示例中所示模式相似的字段对象的列表。
示例:多值输入
在该示例中,第一个参数是由要素类构成的多值。 多值中的每个要素类均复制到派生工作空间中。 新字段 ProjectID 将添加到每个复制的要素类中。
# 0 - input features (multivalue)
# 1 - input workspace
# 2 - derived workspace
import arcpy
class ToolValidator:
 def __init__(self):
     self.params = arcpy.GetParameterInfo()
 def initializeParameters(self):
     self.params[2].parameterDependencies = [1]
     self.params[2].schema.clone = True
     return
 def updateParameters(self):
     inVT = self.params[0].value  # multivalue ValueTable
     inWS = self.params[1].value  # WorkSpace
     # Add each feature class to the output workspace. In addition,
     # add a new field "ProjectID" to each feature class.
     if inVT and inWS:
         rowCount = inVT.rowCount  # Number of rows in the MultiValue table
         children = []
         newField = arcpy.Field()
         newField.name = "ProjectID"
         newField.type = "Long"
         for row in range(0, rowCount):
             value = inVT.getValue(row, 0)
             if value:
                 d = arcpy.Describe(value)
                 fieldList = d.fields
                 # Note -- not checking if field already exists
                 fieldList.append(newField)
                 # Create new child with additional ProjectID field and
                 # add child to list of children.
                 child = [d.shapeType, d.catalogPath, fieldList]
                 children.append(child)
         self.params[2].schema.additionalChildren = children
     return
 def updateMessages(self):
     return
Filter 对象
Filter 对象允许为参数指定用户可用的选择。 例如,可设置字段过滤器将选择限制为文本字段。 过滤器执行以下工作:
用户浏览数据时,过滤器提供有效的选择。 如果将过滤器设置为点要素类,则用户浏览数据时仅显示点要素类。 如果将过滤器设置为文本字段,则字段下拉列表仅显示文本字段。
如果用户提供了参数值(而不是从列表或文件浏览器中选择值),则系统会将该值与过滤器进行比较。 如果用户提供的值无效(例如数值字段而不是文本字段),将出现警告或错误。
由于将通过内部验证将值与过滤器进行比较,因此无需对
ToolValidator类中的自定义验证进行编程。
通过执行以下任一操作来指定过滤器:
在工具的属性对话框的参数选项卡上,单击参数,然后单击过滤器旁的单元格,再从下拉列表中选择过滤器类型。 选择过滤器类型之后,将显示一个对话框,可在其中指定过滤器的值。
以编程的方式在
ToolValidator类中设置值(示例如下所示)。 这将提供使用工具的属性对话框无法实现的自定义选项,包括定义基于其他参数值的动态过滤器、复合数据类型的过滤器以及同一参数上的多个过滤器类型。 地理处理将自动为字符串、长整型、双精度型、要素类、文件、字段和工作空间类型的参数创建过滤器。 如果您未在工具的属性对话框中选择过滤器,过滤器仍与参数相关联 - 但它是空的。 空过滤器等同于没有过滤器。 通过向空过滤器添加值,可以激活过滤器,并且用户的选择仅限于过滤器内容。
下表描述了过滤器类型:
|
过滤器类型 |
值 |
|---|---|
|
ValueList |
与字符串、长整型、双精度、布尔型、线性单位、面积单位和时间单位数据类型一起使用的字符串或数值列表。 对于字符串或数字过滤器,请提供值列表,只有这些值将被视为有效并显示在工具对话框的下拉列表中。 对于线性单位、面积单位和时间单位 ValueList 过滤器,请提供单位关键字字符串列表,只有使用这些单位的值才会被视为有效并显示在工具对话框的单位下拉列表中。 |
|
范围 |
用于长整型、双精度、线性单位、面积单位和时间单位数据类型的最小值和最大值。 对于长整型和双精度过滤器,请提供包含两项的列表:最小值和最大值。 只有在最小值和最大值之间指定的数字才会被视为有效。 对于线性单位、面积单位和时间单位范围过滤器,请提供包含两项的列表:包含单位的最小值和最大值,例如 |
|
FeatureClass |
通过值 |
|
文件 |
文件后缀列表,例如 |
|
字段 |
通过值 |
|
工作空间 |
通过值 |
|
出行模式单位类型 |
允许的出行模式阻抗属性列表,由 |
属性
下表介绍了过滤器属性。
|
属性 |
描述 |
|---|---|
|
|
过滤器的类型(ValueList、范围、要素类、文件、字段和工作空间)。 使用长整型、双精度型、线性单位、面积单位和时间单位参数时,可设置过滤器类型。 对于其他类型的参数,仅有一种有效的过滤器类型,所以可以忽略这些参数的类型设置。 如果不想过滤值,可将 |
|
|
过滤器的值列表。 如果不想过滤值,可将此属性设置为空列表。 |
ValueList
下方小节中提供了 ValueList 过滤器信息。
用于字符串参数的 ValueList
对于字符串参数,列表可包含任意数量的字符串。 下面显示了在 initializeParameters 中设置字符串值列表的示例。 参数包含两个选项:"NEW_FORMAT" 和 "OLD_FORMAT"。
def initializeParameters(self):
 # Set the fixed list of "file format type" parameter choices and its
 # default value.
 self.params[1].filter.list = ["OLD_FORMAT", "NEW_FORMAT"]
 self.params[1].value = "OLD_FORMAT"
 return
在上面的示例中,可以在工具属性对话框的参数选项卡中设置值列表。 如果在工具属性中将值列表设置为其他值(例如 “OLD” 和 “NEW”),则在调用 initializeParameters 时这些值将替换为 "OLD_FORMAT" 和 "NEW_FORMAT"。 对于默认值来说也是这样 - 可在工具属性对话框中设置默认值,并在 ToolValidator 中进行重置。
注:
在 ToolValidator 中提供的值列表将替换工具属性对话框中设置的值。 这允许您基于其他参数更新值。
继续讲述该示例,以下代码显示了 updateParameters 根据用户是选择 "OLD_FORMAT" 还是 "NEW_FORMAT" 来更改另一个参数中的值列表:
def updateParameters(self):
 # Update the value list filter of the "feature type in file" parameter
 # depending on the "file format type" parameter.
 if self.params[1].value.upper() == "OLD_FORMAT":
     self.params[2].filter.list = ["POINT", "LINE", "POLYGON"]
 elif self.params[1].value.upper() == "NEW_FORMAT":
     self.params[2].filter.list = ["POINT", "LINE", "POLYGON",
                                   "POINT_WITH_ANNO",
                                   "LINE_WITH_ANNO",
                                   "POLYGON_WITH_ANNO"]
 # Provide default value for "feature type in file" parameter.
 if not self.params[2].altered:
     self.params[2].value = "POINT"
用于长整型参数和双精度型参数的 ValueList
长整型参数或双精度型参数可具有数值列表。 用户仅可选择或输入列表中的值。
# Set filter for a Long parameter
self.params[7].filter.list = [10, 20, 30, 40, 50]
# Set filter for a Double parameter
self.params[8].filter.list = [10.0, 12.5, 15.0]
用于布尔型参数的 ValueList
布尔参数的值为 true 和 false。 值 true 始终是列表中的最初值。
def initializeParameters(self):
 # Set the Boolean choice for including or excluding angles.
 self.params[6].filter.list = ["ANGLE", "NO_ANGLE"]
 # Set the default value to false (no angle).
 self.params[6].value = "NO_ANGLE"
 return
def updateParameters(self):
 # Enable angle format parameter if user wants angles.
 if self.params[6].value.upper() == "ANGLE":
     self.params[7].enabled = True
线性单位、面积单位和时间单位参数的 ValueList
线性单位、面积单位和时间单位参数可以有单位列表。 用户仅可选择或输入列表中的单位
# Set filter for linear unit parameters
self.params[5].filter.type = "ValueList"
self.params[5].filter.list = ["Meters", "Kilometers"]
# Set filter for areal unit parameters
self.params[6].filter.type = "ValueList"
self.params[6].filter.list = ["Hectares", "SquareKilometers", "SquareMeters"]
# Set filter for time unit parameters
self.params[7].filter.type = "ValueList"
self.params[7].filter.list = ["Hours", "Days"]
范围
长整型、双精度型、线性单位、面积单位和时间单位参数可以有范围过滤器。 范围过滤器有两个值:最小值和最大值。 列表中的第一个值是最小值。 包括范围边界值,这表示最小值和最大值也是有效数据。
长整型和双精度型参数的范围
长整型参数或双精度型参数可具有有效数值的范围。
def initializeParameters(self):
 # Utility values must be between -10 and 10.
 self.params[7].filter.list = [-10, 10]
线性单位、面积单位和时间单位参数的范围
线性单位、面积单位或时间单位参数可以有有效值的范围。 用户可以指定任何单位,它将自动转换以与范围过滤器的最小值和最大值的单位进行比较。
# Set filter for linear unit parameters
self.params[5].filter.type = "Range"
self.params[5].filter.list = ["1 Meters", "10 Meters"]
# Set filter for areal unit parameters
self.params[6].filter.type = "Range"
self.params[6].filter.list = ["1 Acres", "10 Acres"]
# Set filter for time unit parameters
self.params[7].filter.type = "Range"
self.params[7].filter.list = ["1 Hours", "24 Hours"]
设置长整型、双精度型、线性单位、面积单位和时间单位参数的过滤器类型
对于长整型、双精度型、线性单位、面积单位和时间单位参数,ValueList 是默认的过滤器类型。 如果要将其更改为 Range 过滤器,可在 initializeParameters 中将过滤器类型设置如下:
def initializeParameters(self):
 # Set the 'score' value parameters to a range filter
 self.params[7].filter.type = "Range"
 self.params[7].filter.list = [-10, 10]
# Set both filter types for a single Linear Unit parameter
self.params[5].filter.type = "Range"
self.params[5].filter.list = ["0 Meters", "10000 Meters"]
self.params[5].filter.type = "ValueList"
self.params[5].filter.list = ["Meters", "Kilometers", "Feet", "Miles", "Yards"]
仅可设置长整型、双精度型、线性单位、面积单位和时间单位参数的过滤器类型。
FeatureClass
以下示例显示了如何根据另一个输入参数的要素类型设置某个输入参数的要素类型。
def updateParameters(self):
 # Set the input feature type of the second parameter based
 # on the feature type of the first parameter.
 if self.params[0].valueAsText:
     desc = arcpy.Describe(self.params[0])
     feature_type = desc.shapeType.lower()
     if feature_type == "polygon":
         self.params[1].filter.list = ["point", "multipoint"]
     elif feature_type == "polyline":
         self.params[1].filter.list = ["polygon"]
     elif feature_type in ["point", "multipoint"]:
         self.params[1].filter.list = ["polyline"]
     else:
         self.params[1].filter.list = []
 return
文件
文件过滤器包含文件可具有的文件后缀的列表,如 .txt(简单文本文件)和 .csv(逗号分隔值)。 您可以提供任何后缀的文本,不必是 ArcGIS 可识别的后缀。 后缀可为任意长度,且不包含句点。 以下示例显示了如何为输入的“文件”类型参数设置过滤器。
def initializeParameters(self):
 # Set the input file type to recognized options file suffixes.
 self.params[0].filter.list = ["opt56", "opt57", "globalopt"]
 return
字段
字段过滤器用于定义允许的字段类型: 值可以为 "Short"、"Long"、"Float"、"Single"、"Double"、"Text"、"Date"、"OID"、"Geometry"、"Blob"、"Raster"、"GUID"、"GlobalID" 和 "XML"。
显示名称与内部名称
下表显示了具有内部名称的字段类型:
|
显示名称 |
内部名称 |
|---|---|
|
短整型 |
|
|
长整型 |
|
|
浮点型 |
|
|
文本 |
|
在指定字段过滤器时,可以使用显示名称,也可以使用内部名称;也就是说,下列两行代码是等效的:
self.params[1].filter.list = ["Short", "Long", "Float", "Text"]
self.params[1].filter.list = ["SmallInteger", "Integer", "Single", "String"]
如果提供了显示名称,例如 "short",在过滤器中就会转换并存储为 "SmallInteger"。 您可能不需要访问字段过滤器中的值,但是如果需要,请注意存储的是内部名称。 下面的代码片段对这一点做出解释:
self.params[1].filter.list = ["Short", "Long"]
if self.params[1].filter.list[0].lower() == "SmallInteger":
 print('Do something')
设置默认字段值
可通过循环浏览输入表中的字段,然后选择满足过滤器的第一个字段来提供字段参数的默认值。
def initializeParameters(self):
 self.params[1].filter.list = ["Short", "Long", "Float", "Double"]
 return
def updateParameters(self):
 if self.params[0].valueAsText and not self.params[1].altered:
     self.params[1].value = ""
     desc = arcpy.Describe(self.params[0])
     fields = desc.fields
     # Set default to the first field that matches your filter.
     for field in fields:
         fType = field.type.lower()
         if fType in ["SmallInteger", "Integer", "Single", "Double"]:
             self.params[1].value = field.name
             break
 return
注意:
不要在 ToolValidator 中使用 ListFields 函数。 改用如上所示的 Describe 函数。
工作空间
工作空间过滤器用于指定允许的输入工作空间的类型,这些类型将在下面的表格中进行介绍:
|
工作空间过滤器 |
描述 |
|---|---|
|
|
系统文件夹,用于存储 shapefile 和格网 |
|
|
文件地理数据库 |
|
|
企业级数据库连接 |