適合性モデラーの比較ウィンドウ
 Spatial Analyst ライセンスで利用可能。
比較 ウィンドウは、モデル比較 インターフェイスのメイン ウィンドウです。 このウィンドウから、次のアクションを実行できます。
比較モデルに名前を付ける。
比較する適合性モデルを識別する。
モデルを正規化する必要があるかどうかを判断する。
実行する定義済みの統計を選択する。
少なくとも 2 つのモデルを選択する必要があります。
比較 ウィンドウでは、定義済みの統計が 5 つの機能グループに分かれています。 実行する統計を選択するには、ウィンドウで機能グループ内にある目的の統計の横にあるチェックボックスを選択します。
選択した統計を実行するには、ウィンドウの 実行 ボタンをクリックします。
実行 ボタンをクリックすると、統計の探索 ウィンドウと 比較統計ウィンドウ が開き、リストの最初の統計が表示されます。 以前に実行した他の統計の結果を表示するには、統計の探索 ウィンドウでその統計をクリックします。
他の定義済みの統計を実行するには、統計の探索 ウィンドウの左上にある、戻る矢印をクリックします。 実行する別の統計を選択すると、比較 ウィンドウの右下にある マップ操作 ボタンが 実行 に変わります。 実行 ボタンをもう一度クリックすると、特定した追加の統計のみが実行され、統計の探査 ウィンドウが再び表示されます。
他の統計を追加せず、統計の探索 ウィンドウに戻って以前に実行した他の統計を表示する場合は、比較 ウィンドウの右下にある マップ操作 ボタンをクリックします。
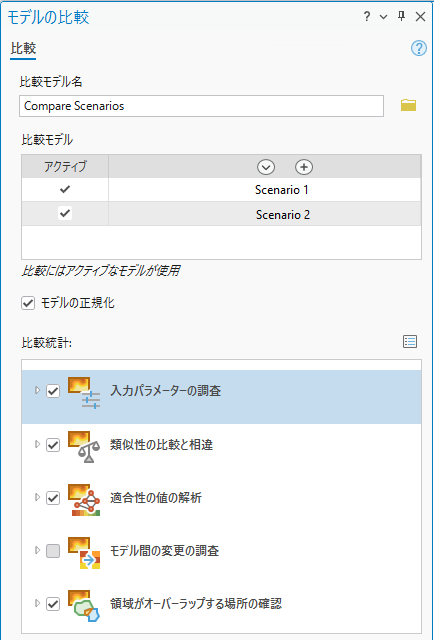
使用できる定義済みの統計
定義済みの統計は、モデル比較 インターフェイスの核心です。 これらは、5 つの機能グループに分類されています。
入力パラメーターの調査 では、各入力モデルのパラメーターを表示できます。
類似性の比較と相違 では、モデルが一致する場所と異なる場所を識別できます。
適合性の値の解析 では、モデルが一致する場所と一致しない場所だけでなく、適合性の値が高いエリアと低いエリアを判定できます。
モデル間の変更の調査 では、入力モデル間で適合性の値がどのように変化するかを解析できます。
領域がオーバーラップする場所の確認 では、入力モデルからの領域がオーバーラップする場所を確認できます。
定義済みの統計の比較
次のセクションでは、実行する統計を選択できるように、5 つの機能グループごとにさまざまな統計について説明します。 まず機能グループを示してから、そのグループ内にある統計を説明します。 ほとんどの統計には、次のサブセクションがあります。
説明: 統計の仕組み。
使用する状況: その統計を適用できる場合を示します。
式: その統計の基になる演算を提供します。
グループ 1: 入力パラメーターの調査
入力パラメーターの調査 機能グループにある統計は 1 つです。
統計: モデルのパラメーター
モデルのパラメーター 統計の説明と、使用する状況について説明します。
説明
この統計を使用すると、入力パラメーターと生成されるマップの間の類似性と相違を調べることができます。 適合性と場所検索マップを表示して、入力条件ごとの変換プロットを並べて比較することができます。
使用する状況
この統計は、入力モデルの構成を理解するために使用します。 各モデルの条件、条件の変換方法、最終的な適合性と領域マップを確認できます。 この統計は、残りの統計を文脈の中で捉えられるように、モデルの概要を提供します。 この統計により、入力モデルの詳細を確認できます。
グループ 2: 類似性の比較と相違
類似性の比較と相違 機能グループには、次の 4 つの統計があります。
統計: 適合性の値の差異
適合性の値の差異 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、2 つのモデル間の適合性の値が類似している場所と異なる場所を識別します。 2 つのオプションが利用できます。
変化率 オプションは、Model 1 から Model 2 への適合性の値の変化 (%) を計算します。 モデル 2 の値が減少している場合、変化 (%) は正の値になります。 この値が増加している場合、変化 (%) は負の値になります。 正の値が大きいほど、また負の値が小さいほど、差異が大きいことを示します。
パーセント差 オプションは、Model 1 と Model 2 の間で適合性の値間の変化 (%) の絶対値を計算します。 値が小さいほど、2 つのモデル間で適合性の値の類似性が高くなります。
使用する状況
これは、モデルが類似している場所と異なる場所について初期の認識を得るために適用する最初の統計の 1 つです。 残りの統計はこれを基礎として定義されるため、この統計はすべてのモデル比較アプリケーションに適用できます。
式
この統計の式は、次の形式で表されます。
PercentChange = (Model1 - Model2) / Model1 * 100
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。
統計: モデル間の類似性
モデル間の類似性 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、2 つのモデル間の適合性の値が最も類似している場所を識別します。
パーセント セルから を適用すると、セルの総数に対する割合が類似性閾値以下になるまで、パーセントの絶対差が最も小さいセルが選択されます。 値から を選択すると、結果として得られる場所は、2 つのモデル間のパーセントの絶対差が類似性閾値以下の場所です。
パーセントの絶対差の値が表示されます。
使用する状況
この統計は、適合性の値の差異 統計の出力を補完します。 この統計は、最も類似している場所の空間分布を解析するために使用します。 大多数のアプリケーションでは、モデルが一致する場所に関心があります。 必要なセルの数に既知の制限がある場合や、類似性の構成要素を定義する特定の閾値がある場合、この統計を使用します。
式
この統計の式は、次の形式で表されます。
Con(PercentDifference <= Similarity_Threshold, PercentDifference)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Similarity_Threshold: 閾値以下の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似していると見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も小さいセルの総数の 10% 以下です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
値が最も小さい位置は、モデル同士が最も類似している位置を示します。
統計: 類似性と相違
類似性と相違 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、モデルが類似している場所と異なる場所を比較します。
パーセント セルから を選択すると、セルの総数に対する割合が類似性閾値以下になるまでパーセントの絶対差が最も小さいセルが選択され、セルの総数に対する割合が差異の閾値以上になるまで差異が最も大きいセルが選択されます。 値から を選択すると、出力は、パーセントの絶対差が類似性閾値以下である場所、またはパーセント差が差異の閾値以上である場所を識別します。
使用する状況
この統計は、モデルが類似している場所と異なる場所を確認するために使用します。 モデル間の類似性 統計とは異なり、類似性と相違 にはモデル間の相違も含まれています。 その結果、モデルが一致する場所と一致しない場所の空間リレーションシップを解析できます。 各モデルの最終的な領域が表示されている場合は、モデルが類似している場所と異なる場所を基準にして、それらの場所を調べることができます。
式
この統計の式は、次の形式で表されます。
Con(PercentDifference <= Similarity_Threshold, 1, Con(PercentDifference >= Difference_Threshold, 2))
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
ここでは、
Model 1: Model 1 の名前Model 2: Model 2 の名前Similarity_Threshold: 閾値以下の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似していると見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も小さいセルの総数の 10% 以下です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
Difference_Threshold: 閾値以上の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似しないと見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も大きいセルの 90% 以上 (分析範囲内で絶対差が最も大きいセルの上位 10%) です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
統計: 差異のクラスター (ホット スポット分析)
差異のクラスター (ホット スポット分析) 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、モデル間のパーセントの絶対差がクラスタリングしているかどうかを識別します。
適合性マップ間のパーセントの絶対差が計算されます。 指定した数のポイントの値が、パーセントの絶対差ラスターから抽出されます。 それらのポイントでホット スポット分析が実行されます。
クラスター パターンはモデル間のパーセントの絶対差から計算されます。 結果のクラスターは差異が大きい場所 (ホット スポット) または差異が小さい、類似する場所 (コールド スポット) を示します。
この解析では、各場所におけるパーセントの絶対差および識別された近接フィーチャの値が考慮されます。
結果は、適合性マップの最も粗い解像度でラスター化されたレイヤーとして表示されます。
使用する状況
この統計は、類似性と相違 統計と組み合わせて使用できます。 この統計は、モデルが類似している場所と異なる場所を識別するだけでなく、特定位置の差異と周辺位置の差異も含みます。 計算に近接フィーチャを含めることで、解析の適用範囲が広がり、幅広いパターンが明らかになります。
式
この統計の式は、次の形式で表されます。
HotSpotAnalysis(PercentDifference, Conceptualization_of_Spatial_Relationships, Distance_Method, Distance_Band_or_Threshold_Distance_or_Number_of_Neighbors)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Conceptualization_of_Spatial_Relationships: ポイント間の空間リレーションシップを定義する方法を識別します。 デフォルトは 固定距離バンド です。加重平均距離 : 遠くにあるポイントよりも、隣接するポイントの方が、ターゲット ポイントの計算により大きな影響を与えます。
加重平均距離の二乗 : 加重平均距離 と同じですが、傾斜が急なため、影響度がより急速に低下する点と、ターゲット ポイントに最も近い隣接ポイントだけがそのポイントの計算に実質的影響を与える点が異なります。
固定距離バンド : 各ポイントは、隣接ポイントのコンテキスト内で解析されます。 指定した臨界距離 (距離バンド または 距離の閾値) 内の隣接ポイントは、加重 1 を受け取り、ターゲット ポイントの計算に影響を与えます。 臨界距離の外にある隣接ポイントは、加重 0 を受け取り、ターゲット ポイントの計算に影響を与えません。
無関心領域: ターゲット ポイントの指定した臨界距離 (距離バンド または 距離の閾値) 内のポイントは、加重 1 を受け取り、ターゲット ポイントの計算に影響を与えます。 臨界距離を超えると、加重 (および隣接ポイントがターゲット ポイントの計算に与える影響) は距離に伴って減少します。
K 最近隣内挿法 : 最も近い k 個のポイントが分析に含められます。k は指定した数値パラメーターです。
Distance Method: 各ポイントから隣接ポイントまでの距離の計算方法を指定します。 デフォルト値は ユークリッド であり、すべてのポイントに 1 つ以上の隣接フィーチャがあることが保証されます。ユークリッド : 2 つのポイント間の直線距離 (最短距離) が使用されます。
マンハッタン : x 座標と y 座標の間の (絶対) 差を合計することで計算された、直角の軸 (街区) に沿って計測した 2 つのポイント間の距離が使用されます。
Distance_Band_or_Threshold_Distance_or_Number_of_Neighbors: 空間リレーションシップのコンセプトの選択に基づいて、パラメーターが変化します。
Distance_Band_or_Threshold_Distance : 加重平均距離オプションおよび固定距離オプションのカットオフ距離。 ターゲット ポイントに対して指定したカットオフの外側のポイントは、ターゲット ポイントの解析では除外されます。 ただし、無関心領域 オプションの場合、距離の閾値内にあるポイントの影響は等しく考慮され、指定した距離の外側にあるポイントの影響は距離に伴って減少します。 入力する距離値は、出力座標系の値と一致している必要があります。
空間リレーションシップの加重平均距離のコンセプト : 値 0 は閾値の距離が適用されないことを示します。 このパラメーターを空白のままにすると、デフォルトの閾値が計算され、適用されます。
Number_of_Neighbors : 解析に含まれる近傍の数を指定する整数。 デフォルトは 8 です。
Percent Sampling: ホット スポット分析で使用される適合性マップから派生したパーセントの絶対差ラスターから取得されるポイントの数を識別します。ポイント数は、適合性マップ内のセル数のパーセントとして指定されます。 通常、適合性マップは高い空間的自己相関を示します。 多くの場合、合計で分析範囲内のセル数の 11% (デフォルト) を占める等間隔ポイントを使用すると、適合性マップのリサンプリングされた最適な表現が得られます。
パーセント値によってリサンプリング セル サイズが決まります (パーセント値に比例してセル サイズが増加します)。 このリサンプリングによって、ホット スポット分析でポイントに変換されるラスター セルの数が減ります。 デフォルトの 11% は、粗い解像度の適合性マップの約 3 倍のセル サイズに相当します。 パーセントが小さくなるに従い、ポイントの数が減って間隔が広くなり、パーセントが大きくなるに従い、ポイントの数が増えて空間的詳細度が高くなります。
解析に使用するポイントの最大数は 100 万です。
グループ 3: 適合性の値の解析
適合性の値の解析 機能グループには、次の 4 つの統計があります。
統計: 適合性が高いモデルの類似性
適合性が高いモデルの類似性 統計の説明、使用する状況、統計の式について説明します。
説明
この統計は、2 つのモデル間で類似しており、適合性が高い場所を識別します。
パーセント セルから の方法を使用すると、パーセントの合計が類似性閾値以下になるまで、パーセントの絶対差が最も小さいセルが選択されます。 選択したこれらのセルの適合性の平均値は、高適合性閾値の指定されたパーセンテージを満たすために最終的に選択したセルの最低値よりも高い必要があります。
値から を選択すると、結果のマップには、2 つのモデル間のパーセントの絶対差が類似性閾値以下で、適合性の平均値が高適合性閾値以上の場所の適合性の平均値が示されます。
使用する状況
通常、高い適合性の値は、適合性モデルで最も重要です。 この統計は、モデルが類似している場所を示すだけでなく、類似していて適合性が高い場所も識別します。 この統計は、比較解析の対象地域を絞り込むために使用します。 最終的な領域がこれらの場所に含まれる場合、2 つのモデルが類似する結果を生成すると確信できます。
式
この統計の式は、次の形式で表されます。
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability >= High_Suitability_Threshold), MeanSuitability)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
MeanSuitability = Mean(Model1, Model2)
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Similarity_Threshold: 閾値以下の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似していると見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も小さいセルの総数の 10% 以下です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
High_Suitability_Threshold: この値を上回ると、位置の適合性が高いと見なされることを示す適合性の値、または分析範囲内で適合性が最も高いセルのパーセント数。デフォルトでは、分析範囲内で適合性の値が最も大きいセルの 90% 以上であるセル (分析範囲内で適合性の平均値が最も大きいセルの上位 10%) が含まれます。
パーセント セルから を選択した場合、これはセルの割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、モデルを正規化すると、2 つの適合性マップ間の平均値の最小値と最大値から範囲が生成され、約 1 ~ 100 (正規化した適合性の値の範囲) になります。 モデルを正規化していない場合、範囲は 2 つの入力適合性モデル間の平均値の範囲になります。
統計: 高適合性の変化率
高適合性の変化率 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、適合性が高い場所における寄与が最も大きいモデルとその大きさを識別します。
パーセント セルから を指定すると、セルの総数に対する割合が高適合性閾値以上になるまで、適合性の平均値が最も大きいセルが選択されます。 これらのセルの変化率が表示されます。 値から を選択すると、結果のマップには、2 つの適合性マップ間の平均値が高適合性閾値以上のエリアの変化率が表示されます。
正の値は Model 1 が最も寄与することを示し、負の値は Model 2 が最も寄与することを示します。 正の値が大きいほど、また負の値が小さいほど、寄与が大きいことを示します。
使用する状況
この統計は、適合性が高いモデルの類似性 統計を強調できます。 この統計は、適合性が高く類似している場所を示すだけでなく、最も寄与しているモデルとその大きさも識別します。 この統計が役に立つのは、加重や変換を変更するときです。その変更が結果に及ぼす空間的な影響について理解を深めることができます。
式
この統計の式は、次の形式で表されます。
Con((MeanSuitability >= High_Suitability_Threshold), (Model1 - Model2) / MeanSuitability * 100)
MeanSuitability = Mean(Model1, Model2)
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。High_Suitability_Threshold: この値を上回ると、位置の適合性が高いと見なされることを示す適合性の値、または分析範囲内で適合性が最も高いセルのパーセント数。デフォルトでは、分析範囲内で適合性の値が最も大きいセルの 90% 以上であるセル (分析範囲内で適合性の平均値が最も大きいセルの上位 10%) が含まれます。
パーセント セルから を選択した場合、これはセルの割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、モデルを正規化すると、2 つの適合性マップ間の平均値の最小値と最大値から範囲が生成され、約 1 ~ 100 (正規化した適合性の値の範囲) になります。 モデルを正規化していない場合、範囲は 2 つの入力適合性モデル間の平均値の範囲になります。
注意:
変化率 の式は、適合性の値の差異の統計での 変化率 オプションとは若干異なります。
統計: 適合性が高いモデルの類似性と相違
適合性が高いモデルの類似性と相違 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、2 つのモデル間で類似している場所と異なる場所、かつ適合性が高い場所を識別します。
パーセント値から を指定すると、高適合性閾値に達するまで適合性の平均値が最も高いセルが選択されます。これらは、セルの総数に対する割合が類似性閾値以下になるまでパーセントの絶対差が最小であるか、セルの総数に対する割合が差異の閾値以上になるまでパーセントの絶対差が最大であるセルです。
値から を指定すると、2 つのモデル間のパーセントの絶対差が類似性閾値以下であるか、パーセントの絶対差が差異の閾値以上であり、適合性の平均値が高適合性閾値以上であるセルが選択されます。
使用する状況
この統計は 類似性と相違 統計に似ていますが、適合性も高いエリアを絞り込みます。 この統計を使用すると、モデルが類似している場所と異なる場所を確認できます。 適合性が高く差異が大きい場所は、モデル同士が大きく異なる場所を示しているため注意が必要です。最終的な領域がその中に含まれると問題になる可能性があります。
式
この統計の式は、次の形式で表されます。
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability >= High_Suitability_Threshold), 1, Con((PercentDifference >= Difference_Threshold) & (MeanSuitability >= High_Suitability_Threshold), 2))
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
MeanSuitability = Mean(Model1, Model2)
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Similarity_Threshold: 閾値以下の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似していると見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も小さいセルの総数の 10% 以下です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
Difference_Threshold: 閾値以上の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似しないと見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も大きいセルの 90% 以上 (分析範囲内で絶対差が最も大きいセルの上位 10%) です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
High_Suitability_Threshold: この値を上回ると、位置の適合性が高いと見なされることを示す適合性の値、または分析範囲内で適合性が最も高いセルのパーセント数。デフォルトでは、分析範囲内で適合性の値が最も大きいセルの 90% 以上であるセル (分析範囲内で適合性の平均値が最も大きいセルの上位 10%) が含まれます。
パーセント セルから を選択した場合、これはセルの割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、モデルを正規化すると、2 つの適合性マップ間の平均値の最小値と最大値から範囲が生成され、約 1 ~ 100 (正規化した適合性の値の範囲) になります。 モデルを正規化していない場合、範囲は 2 つの入力適合性モデル間の平均値の範囲になります。
統計: 適合性が低いモデルの類似性
適合性が低いモデルの類似性 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、2 つのモデル間で類似しており、適合性が低い場所を識別します。
パーセント セルから を指定すると、セルの総数に対する割合が類似性閾値以下になるまでパーセント差が最も小さいセルが選択されます。これらは、低適合性閾値に達するまで適合性の平均値が最も小さくなります。 値から を選択すると、結果のマップには、2 つのモデル間のパーセントの絶対差が類似性閾値以下で、適合性の平均値が低適合性閾値以下の場所の適合性の平均値が示されます。
使用する状況
この統計は、適合性が低い場所についてモデルが一致するかどうかを示します。 この統計は、モデル間で高い適合性の値が一致するだけでなく、低い適合性の値も一致することを確認するために使用します。
式
この統計の式は、次の形式で表されます。
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability <= Low_Suitability_Threshold), MeanSuitability)
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Similarity_Threshold: 閾値以下の値を持つセルが統計で選択されます。 選択したセルの位置において、モデル同士が最も類似していると見なされます。デフォルトは、分析範囲内でパーセントの絶対差が最も小さいセルの総数の 10% 以下です。
パーセント セルから を選択した場合、これはセルの総数に対する割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、正規化を選択しているかどうかにかかわらず、適合性マップ間のパーセントの絶対差の最小値と最大値から範囲が生成されます。 ただし、2 つの範囲は異なる場合があります。
Low_Suitability_Threshold: この値を下回ると、位置の適合性が低いと見なされること示す適合性の値、または分析範囲内で適合性が最も低いセルのパーセント数。パーセント セルから を選択した場合、これはセルの割合を表すため、正規化オプションを選択しているかどうかにかかわらず、範囲は 1 ~ 100 になります。 値から を選択した場合、モデルを正規化すると、2 つの適合性マップ間の平均値の最小値と最大値から範囲が生成され、約 1 ~ 100 (正規化した適合性の値の範囲) になります。 モデルを正規化していない場合、範囲は 2 つの入力適合性モデル間の平均値の範囲になります。
グループ 4: モデル間の変更の調査
モデル間の変更の調査 機能グループには、次の 2 つの統計があります。
統計: 適合性の値間の空間的関連性
適合性の値間の空間的関連性 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、エリアと定義済みの近傍内における適合性値の間の類似性を計算します。
指定した数のポイントの値が、2 つの適合性マップから抽出されます。 それらのポイントで 2 変量空間的関連性分析が実行されます。 結果は、最も粗い解像度の適合性マップと同じ解像度でラスター化されたレイヤーとして表示されます。
2 つの適合性マップ間の空間的関連性は、Lee's L 統計を使用します。 出力は 5 つの空間関連カテゴリーに分かれています。
高 - 高カテゴリーは、そのセルの有意性が 90% 以上であり、両方のモデルの近傍加重平均の適合性が高いと見なされることを意味しています。
低 - 低カテゴリーは、そのセルの有意性が 90% 以上であり、両方のモデルの近傍加重平均の適合性が低いと見なされることを意味しています。
低 - 高カテゴリーは、そのセルの有意性が 90% 以上であり、1 つ目のモデルの近傍加重平均の適合性が低いと見なされ、2 つ目のモデルの適合性が高いと見なされることを意味しています。
高 - 低カテゴリーは、そのセルの有意性が 90% 以上であり、1 つ目のモデルの近傍加重平均の適合性が高いと見なされ、2 つ目のモデルの適合性が低いと見なされることを意味しています。
有意でないとは、2 つのモデル間の空間相関が有意でないことを意味します。
使用する状況
この統計は、モデルが類似している場所と異なる場所を調べる統計を補完します。 この統計によって、モデル間で高い値が高い値に対応し、低い値が低い値に対応するかどうかを定量化することで、さらなる知見を得ることができます。 高い値と低い値が揃っている場合、問題はありません。 値が異なる (高 - 低または低 - 高) 場所は、追加の解析が必要となる場所です。
式
この統計の式は、次の形式で表されます。
BivariateSpatialAssociation(Model1, Model2, Neighborhood_Type, Distance_Band_or_Number_of_Neighbors)
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Neighborhood_Type: 各ポイントの近接フィーチャの特定方法を指定します。 ポイントは近傍に必ず含まれ、すべての近傍加重は合計が 1 となるように正規化されます。固定距離バンド : 各ポイントの指定した臨界距離内にあるポイントが近傍として含められます。 これがデフォルトです。
K 最近隣内挿法 : 最も近い k 個のポイントが近傍として含められます。
Distance_Band_or_Number_of_Neighbors: 近傍タイプの選択に基づいて、パラメーターが変化します。
Distance_Band : 中心点の周囲の近接フィーチャを特定する際に使用する距離バンドを識別します。 値を指定していない場合、この距離は、各ポイントの近傍に他の近接フィーチャが 1 つ以上含まれる最短距離になります。
Number_of_Neighbors : 近接フィーチャとして含まれる、各ポイントの周囲の近接フィーチャの数を識別します。 この値にはポイントは含まれません。 たとえば、6 を指定した場合、ポイントとそれに最も近い 6 つの近接フィーチャ (合計 7 つのポイント) が使用されます。 デフォルトは 8 です。 この値は 2 以上でなければなりません。
Percent Sampling of Suitability Map: 解析で使用される適合性マップから派生したパーセントの絶対差ラスターから取得されるポイントの数を識別します。ポイント数は、適合性マップ内のセル数のパーセントとして指定されます。 通常、適合性マップは高い空間的自己相関を示します。 多くの場合、合計で分析範囲内のセル数の 11% (デフォルト) を占める等間隔ポイントを使用すると、適合性マップのリサンプリングされた最適な表現が得られます。
パーセント値によってリサンプリング セル サイズが決まります (パーセント値に比例してセル サイズが増加します)。 このリサンプリングによって、解析でポイントに変換されるラスター セルの数が減ります。 デフォルトの 11% は、粗い解像度の適合性マップの約 3 倍のセル サイズに相当します。 パーセントが小さくなるに従い、ポイントの数が減って間隔が広くなり、パーセントが大きくなるに従い、ポイントの数が増えて空間的詳細度が高くなります。
解析に使用するポイントの最大数は 100 万です。
統計: 適合性の値の変化 (変化の検出)
適合性の値の変化 (変化の検出) 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、適合性の値が Model 1 から Model 2 へとどのように変化するかを識別します。
2 つの適合性マップ間の適合性カテゴリーの差異を計算します。 各カテゴリーのクラスを作成するため、等間隔法を使用してマップ内の適合性の値が指定したクラス数に分割されます。 作成された適合性クラスから、統計によって、場所ごとに、適合性クラスが Model 1 から Model 2 に変化するかどうか、クラスが変化するか、クラスが何に変化するかが識別されます。
等間隔法を使用してクラスが作成され、適合性の値の相対的関係が維持されます。
使用する状況
この統計は、適合性の値がモデル間でどのように変化するかを定量化するために使用します。 この統計は、What-if シナリオをテストするのに最適です。 これらのシナリオでは、サブモデルまたは条件間の加重、条件の変換、または入力条件を変更した場合の影響を調査します。 この統計を使用すると、それぞれの変更が出力にどのように影響するかを調べることができます。
式
この統計の式は、次の形式で表されます。
Combine([Reclass_model1, Reclass_model2])
Reclass_model1 = Slice( Model1, Number_of_Classes, slice_type="EQUAL_INTERVAL")
Reclass_model2 = Slice( Model2, Number_of_Classes, slice_type="EQUAL_INTERVAL")
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。Number_of_Classes: 適合性カテゴリーを作成するために適合性の値を再分類 (グループ化) するクラスの数。 3 と 5 の 2 つのオプションがあります。 デフォルトは 3 です。
グループ 5: 領域がオーバーラップする場所の確認
領域がオーバーラップする場所の確認 機能グループには、次の 2 つの統計があります。
統計: 領域のオーバーラップ
領域のオーバーラップ 統計の説明、使用する状況、および統計の式について説明します。
説明
この統計は、結果の領域がオーバーラップするエリアとオーバーラップしないエリアを識別します。
2 つのモデル間の領域のオーバーラップを定義する 3 つの条件があります。
その場所が領域内にあり、Model 1 にのみ存在する。
その場所が領域内にあり、Model 2 にのみ存在する。
その場所が領域内にあり、Model 1 と Model 2 に存在する。
領域内の Model 1 と Model 2 に存在する場所は、これらのモデルが一致する場所を示します。 一般に、オーバーラップ度合いが高いほど、モデル間の一致レベルが高いことを示します。
使用する状況
この統計は、最終的な領域が一致する場所と異なる場所を示します。 この統計は、最終的な領域を特定して、両方のモデルで選択された場所を確認するときはいつでも使用します。 領域間のオーバーラップがほとんどない場合、モデル間のモデル パラメーターの変更によって出力が大きく変化し、モデルに互換性がないことを示します。
式
この統計の式は、次の形式で表されます。
上記の説明セクションの 3 つのシナリオを識別する条件ステートメント。
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。
統計: 適合性レベルでの領域のオーバーラップ
適合性レベルでの領域のオーバーラップ 統計の説明、使用する状況、統計の式について説明します。
説明
この統計は、結果の領域がオーバーラップする場所としない場所、ある領域に属する各場所の適合性レベルを識別します。
2 つのモデル間の領域のオーバーラップを定義する 9 つの条件があります。
その場所が領域内にあり、Model 1 にのみ存在し、適合性が高い。
その場所が領域内にあり、Model 1 にのみ存在し、適合性が中程度である。
その場所が領域内にあり、Model 1 にのみ存在し、適合性が低い。
その場所が領域内にあり、Model 2 にのみ存在し、適合性が高い。
その場所が領域内にあり、Model 2 にのみ存在し、適合性が中程度である。
その場所が領域内にあり、Model 2 にのみ存在し、適合性が低い。
その場所が領域内にあり、Model 1 と Model 2 に存在し、適合性が高い。
その場所が領域内にあり、Model 1 と Model 2 に存在し、適合性が中程度である。
その場所が領域内にあり、Model 1 と Model 2 に存在し、適合性が低い。
その場所が Model 1 または Model 2 にのみ存在するか、Model 1 と 2 に存在し、適合性が高い場合、これは適合性が高いため、一般に、その場所についてはほとんど問題がありません。
その場所は Model 1 または Model 2 にのみ存在するか、Model 1 と Model 2 に存在し、適合性が中程度か低いため、さらに調査する必要があります。
使用する状況
この統計によって、領域のオーバーラップ 統計に追加の知見を得ることができます。 オーバーラップがあまりない場合は、この統計を使用します。 この統計は、モデル間の最終的な領域がオーバーラップする場所とオーバーラップしない場所を識別するだけでなく、その場所の適合性の値も識別します。 モデル内でオーバーラップしていないが適合性が高い領域は、問題ありません。
式
この統計の式は、次の形式で表されます。
High_Suitability_Threshold パラメーターと Medium_Suitability_Thresholds パラメーターを使用して上記の説明セクションの 9 つのシナリオを識別する条件ステートメント。
ここでは、
Model 1: Model 1 の名前。Model 2: Model 2 の名前。High_Suitability_Threshold: 適合性の値が高いと見なされるセルを識別します。適合性の値がこの閾値以上であるセルは、適合性が高いと見なされる位置 (分析範囲内で適合性が最も高いパーセント数のセル) を示します。
デフォルトでは、分析範囲内で適合性の平均値がセルの 90% 以上 (分析範囲内で適合性の平均値が最も大きいセルの上位 10%) であるセルが選択されます。
Medium_Suitability_Threshold: 適合性の値が中程度と見なされるセルを識別します。適合性の値が中適合性閾値以上かつ高適合性閾値未満のセルは、適合性が中程度と見なされる位置を示します。 つまり、高適合性セルが選択された後で、適合性の値が次に高いパーセント数のセルが選択され、中適合性が割り当てられます。 適合性の値が中適合性閾値よりも小さいセルには、低適合性が割り当てられます。
デフォルトは 80% であり、適合性の平均値が 80% 以上 90% 未満 (高適合性閾値 のデフォルト) であるセル (分析範囲の計 10%) が選択されます。