适宜性建模器中的“比较”窗格
 需具备 Spatial Analyst 许可方可使用。
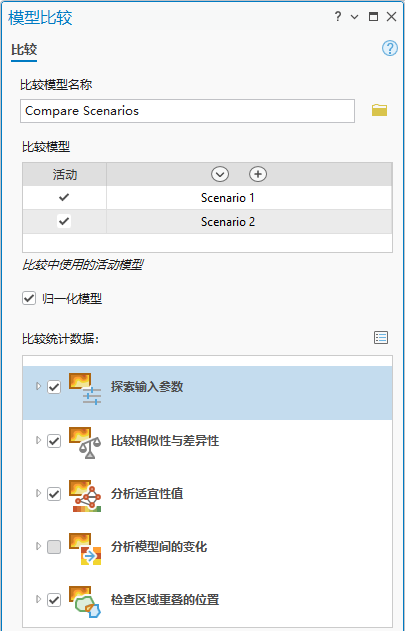
比较窗格是模型比较界面的主窗格。 通过该窗格,可以执行以下操作:
为比较模型命名。
确定要比较的适宜性模型。
确定模型是否应进行归一化处理。
选择要运行的预定义统计量。
必须至少选择两个模型。
在比较窗格中,预定义统计量按功能分为五组。 可以通过在窗格中选中相应功能组内所需统计量旁的复选框,来选择要运行的统计量。
要运行选定的统计量,请单击窗格中的运行按钮。
单击运行按钮后,浏览统计数据窗格和比较统计数据窗格随即出现,并显示列表中的第一个统计数据。 要查看已运行的其他任何统计量的结果,请在浏览统计结果窗格中单击该统计量。
要运行其他预定义统计量,请单击浏览统计结果窗格左上角的返回箭头。 如果您选择了其他要运行的统计量,比较窗格右下角的浏览按钮将变为运行。 当您再次单击运行按钮时,仅运行您指定的额外统计量,并且浏览统计结果窗格会重新出现。
如果您不希望添加任何其他统计量,并希望返回浏览统计数据窗格查看已运行的其他统计量,请单击比较窗格右下角的浏览按钮。
可用的预定义统计量
预定义统计量是模型比较界面的核心。 这些预定义统计量按功能分为五组:
浏览输入参数用于查看每个输入模型的参数。
比较相似性与差异性可用于识别两个模型的相似之处和不同之处。
分析适宜性值不仅用于确定两个模型的相似之处和不同之处,还用于识别这些相似之处和不同之处是在高适宜性值区域还是低适宜性值区域。
分析模型间的变化用于分析两个输入模型之间适宜性值的变化。
检查区域重叠的位置用于查看两个输入模型的区域在何处重叠。
比较预定义统计量
为方便您选择要运行的统计量,以下部分将详细介绍五个功能组中的各项统计量。 首先指明功能组,随后列出该组包含的统计量。 大多数统计量包含以下子部分:
描述:统计量的工作原理。
使用时机:指明您可能希望应用此统计量的情况。
公式:提供统计量的基础数学公式。
组 1:浏览输入参数
浏览输入参数功能组包含一项统计量。
统计量:模型中的参数
以下是模型中的参数统计量的描述及其使用时机。
描述
此统计量可用于检查输入参数与生成的地图之间的相似性与差异性。 您可以查看适宜性地图和定位地图,并可以并排比较每个输入条件的变换图。
何时使用
此统计量用于理解输入模型的构成。 您可以查看每个模型的条件、变换方式以及最终的适宜性地图和区域地图。 此统计量提供了模型的概览,以便结合上下文理解其余统计量的结果。 此统计量可帮助您了解输入模型。
组 2:比较相似性与差异性
比较相似性与差异性功能组包含四项统计量:
统计量:适宜性值差异
以下是适宜性值差异统计量的描述、使用时机及其公式。
描述
此统计量用于确定两个模型之间适宜性值的相似之处和不同之处。 有两个选项可供选择。
百分比变化选项计算适宜性值从模型 1 到模型 2 的百分比变化。 如果模型 2 的值减少,则百分比变化将为正。 如果增加,则百分比变化将为负。 较大的正值和较小的负值可指示差异的幅度较大。
百分比差异选项计算模型 1 和模型 2 的适宜性值之间百分比变化的绝对值。 值越小,两个模型之间的适宜性值越相似。
何时使用
这是您应首先应用的统计量之一,以便初步了解两个模型的相似之处和不同之处。 此统计量适用于所有模型比较应用,因为它提供了定义其余统计量的基础。
公式
此统计的公式为:
PercentChange = (Model1 - Model2) / Model1 * 100
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。
统计量:模型之间的相似性
以下是模型之间的相似性统计量的描述、使用时机及其公式。
描述
此统计量用于识别两个模型之间适宜性值最相似的位置。
当应用按百分比像元后,会选择具有最小绝对百分比差异的像元,直到像元总数的百分比小于或等于相似性阈值。 当选择按值时,结果位置是两个模型之间的绝对百分比差异小于或等于相似性阈值的位置。
将显示绝对百分比差异值。
何时使用
此统计量是对适宜性值差异统计量输出的补充。 此统计量用于分析最相似位置的空间分布。 在大多数应用中,您会关注两个模型的相似之处。 如果您对所需像元数量有已知限制,或有一个定义相似性的特定阈值,请使用此统计量。
公式
此统计的公式为:
Con(PercentDifference <= Similarity_Threshold, PercentDifference)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Similarity_Threshold:将选择统计数据中值小于或等于阈值的像元。 所选像元是模型中被视为最相似的位置。默认值为小于或等于研究区域总像元中绝对百分比差异最小的 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
具有最低值的位置表示模型最相似的位置。
统计量:相似性与差异性
以下是相似性与差异性统计量的描述、使用时机及其公式。
描述
此统计量用于比较模型的相似之处和不同之处。
当选择按百分比像元时,会选择具有最小绝对百分比差异的像元,直到总像元百分比小于相似性阈值,并会选择具有最大差异的像元,直到总像元百分比大于或等于差异阈值。 当选择按值时,输出将识别绝对百分比差异小于或等于相似性阈值或百分比差异大于或等于差异阈值的位置。
何时使用
此统计量用于查看模型的相似之处和不同之处。 与模型之间的相似性统计量不同,相似性与差异性还包括模型之间的差异。 因此,您可以分析模型间相似之处与不同之处之间的空间关系。 如果显示每个模型的最终区域,您可以检查它们相对于模型间相似之处和不同之处的位置。
公式
此统计的公式为:
Con(PercentDifference <= Similarity_Threshold, 1, Con(PercentDifference >= Difference_Threshold, 2))
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
其中:
Model 1:模型 1 的名称Model 2:模型 2 的名称Similarity_Threshold:将选择统计数据中值小于或等于阈值的像元。 所选像元是模型中被视为最相似的位置。默认值为小于或等于研究区域总像元中绝对百分比差异最小的 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
Difference_Threshold:将选择统计数据中值大于或等于阈值的像元。 所选像元是模型中被视为差异最大的位置。默认值为大于或等于研究区域中绝对百分比差异最大的 90% 的像元,即研究区域中绝对差异最高的前 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
统计量:差异聚类(热点分析)
以下是**差异聚类(热点分析)**统计量的描述、使用时机及其公式。
描述
此统计量用于识别是否对模型之间的绝对百分比差异进行聚类。
确定适宜性地图之间的绝对百分比差异。 指定点数的值从绝对百分比差异栅格中提取。 在这些点上执行热点分析。
聚类模式取决于模型之间的绝对百分比差异。 所得到的聚类显示出较大的差异(热点)或差异较小的区域,从而识别出相似的区域(冷点)。
分析考虑了每个位置的绝对百分比差异以及已识别邻域的值。
结果采用与适宜性地图粗糙分辨率以栅格化图层的形式呈现。
何时使用
此统计量可与相似性与差异性统计量结合使用。 此统计量不仅能识别模型之间的相似之处和不同之处,还同时涵盖了特定位置及其周边位置的差异。 通过将邻域纳入计算,扩大了分析范围,从而揭示更广泛的模式。
公式
此统计的公式为:
HotSpotAnalysis(PercentDifference, Conceptualization_of_Spatial_Relationships, Distance_Method, Distance_Band_or_Threshold_Distance_or_Number_of_Neighbors)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Conceptualization_of_Spatial_Relationships:识别点空间关系的定义方式。 默认值为固定距离范围。反距离:相比距离较远的点,与目标点距离更近的邻近点在计算中会产生更大的影响。
反距离平方:此参数与反距离相似,但其斜率更大,因此影响下降得更快,并且仅目标点的最近相邻要素才会对该点的计算产生重大影响。
固定距离范围:每个点都在邻近点的范围内进行分析。 在指定临界距离(距离范围或距离阈值)内的邻近点将分配值为 1 的权重,并对目标点的计算产生影响。 在临界距离外的邻近点将分配值为 0 的权重,并且不会对目标点的计算产生任何影响。
无差别的区域:在目标点的指定临界距离(距离范围或距离阈值)内的点将分配值为 1 的权重,并且会影响该点的计算。 一旦超过临界距离,权重(以及邻近点对目标点计算的影响)会随着距离的增加而逐渐减小。
K 最近邻:最近的 k 点将包括在分析中;k 是指定的数字参数。
Distance Method:指定如何计算从每个点到相邻点的距离。 此默认值为确保每个点至少具有一个相邻点的欧氏距离。欧氏距离:将使用两点间的直线距离。
曼哈顿距离:将使用沿直角坐标轴(街区)计算的两点之间的距离,通过将 x 坐标和 y 坐标的(绝对)差值相加得到。
Distance_Band_or_Threshold_Distance_or_Number_of_Neighbors:参数根据所选的空间关系概念而变化。
Distance_Band_or_Threshold_Distance:“反距离”和“固定距离”选项的中断距离。 将在点分析中忽略为目标点指定的中断之外的点。 但是,对于无差别的区域,指定距离之外的点的影响会随距离的增加而变弱,而距离阈值内的点的影响则被视为是等同的。 提供的距离值应与输出坐标系的值相匹配。
空间关系的反距离概念化:值为 0 表示未应用任何阈值距离。 当将此参数留空时,将计算并应用默认阈值。
Number_of_Neighbors:用于指定将包含在分析中的相邻要素数目的整数。 默认值为 8。
Percent Sampling:确定从派生自适宜性地图的绝对百分比差异栅格获取以用于热点分析的点数。点数指定为适宜性地图中像元数的百分比。 通常,适宜性地图表现出高度的空间自相关性。 使用占研究区域像元总数 11% 的等距点(默认值),通常可以得到适宜性地图的最佳重采样表示。
百分比值通过按比例增加像元大小来确定重采样像元大小。 此重采样可减少将转换为点以用于热点分析的栅格像元的数量。 默认值 11% 对应的像元大小约为适宜性地图较粗分辨率的三倍。 较小的百分比会产生更少、间隔更宽的点,而较大的百分比会产生更多具有更精细空间细节的点。
分析中将使用的最大点数为一百万。
组 3:分析适宜性值
分析适宜性值功能组包含四项统计量:
数据量:高适宜性模型的相似性
以下是高适宜性模型的相似性统计量的描述、使用时机及其公式。
描述
此统计量用于识别在两个模型之间具有相似性且具有高适宜性的位置。
当使用按百分比像元方法时,会选择具有最小绝对百分比差异的像元,直到总百分比小于或等于相似性阈值。 这些所选像元的平均适宜性值还必须高于所选最终像元中的最低值,以满足高适宜性阈值的指定百分比。
当选择按值时,生成的地图将显示适宜性平均值,其中两个模型之间的绝对百分比差值低于或等于相似性阈值,适宜性平均值大于或等于高适宜性阈值。
何时使用
在适宜性模型中,较高的适宜性值通常最为重要。 此统计量不仅显示模型之间的相似之处,还识别出了具有相似性且具有高适宜性的位置。 此统计量用于在比较分析中缩小感兴趣区。 如果最终区域落入这些位置,您可以确信两个模型产生了相似的结果。
公式
此统计的公式为:
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability >= High_Suitability_Threshold), MeanSuitability)
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
MeanSuitability = Mean(Model1, Model2)
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Similarity_Threshold:将选择统计数据中值小于或等于阈值的像元。 所选像元是模型中被视为最相似的位置。默认值为小于或等于研究区域总像元中绝对百分比差异最小的 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
High_Suitability_Threshold:适宜性值(高于该值表示位置被视为具有高适宜性),或研究区域中适宜性值最高的像元所占的百分比。默认值包括的像元大于或等于研究区域中适宜性值最高的 90% 像元,即研究区域中平均适宜性最高的前 10% 的像元。
如果选择按百分比像元,由于它表示像元的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 如果选择按值,则在模型已归一化时,范围将是两个适宜性地图之间的平均值的最小值和最大值,大约为 1 到 100,即归一化适宜性值的范围。 如果模型未归一化,则范围将为两个输入适宜性模型之间的平均值范围。
统计量:高适宜性中的百分比变化
以下是高适宜性中的百分比变化统计量的描述、使用时机及其公式。
描述
此统计量用于识别哪个模型对具有高适宜性的位置的贡献最大以及贡献数量。
在x选定按百分比像元后,适宜性平均值最高的像元将处于选中状态,直到总像元百分比大于或等于高适宜性阈值。 将显示这些像元的百分比变化。 当选择按值时,生成的地图显示两个适宜性地图之间的平均值高于或等于高适宜性阈值的区域的百分比变化。
正值表示模型 1 的贡献最大,负值表示模型 2 的贡献最大。 较大的正值或较小的负值可指示贡献的幅度。
何时使用
此统计量可以强化高适宜性模型的相似性统计量的结果。 此统计量不仅显示具有相似性且具有高适宜性的位置,还识别出了哪个模型贡献最大以及贡献数量。 在更改权重或变换时,此统计量可能很有用,因为您可以更好地了解更改将如何在空间上影响结果。
公式
此统计的公式为:
Con((MeanSuitability >= High_Suitability_Threshold), (Model1 - Model2) / MeanSuitability * 100)
MeanSuitability = Mean(Model1, Model2)
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。High_Suitability_Threshold:适宜性值(高于该值表示位置被视为具有高适宜性),或研究区域中适宜性值最高的像元所占的百分比。默认值包括的像元大于或等于研究区域中适宜性值最高的 90% 像元,即研究区域中平均适宜性最高的前 10% 的像元。
如果选择按百分比像元,由于它表示像元的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 如果选择按值,则在模型已归一化时,范围将是两个适宜性地图之间的平均值的最小值和最大值,大约为 1 到 100,即归一化适宜性值的范围。 如果模型未归一化,则范围将为两个输入适宜性模型之间的平均值范围。
注:
百分比变化公式与适宜性值差异统计中的百分比变化选项略有不同。
统计量:高适宜性模型的相似性与差异性
以下是高适宜性模型的相似性与差异性统计量的描述、使用时机及其公式。
描述
此统计量用于识别在两个模型之间具有相似性与差异性且具有高适宜性的位置。
当选择按百分比值时,会选择平均适宜性值最高的像元直至达到高适宜性阈值,并且选择绝对百分比差异最小的像元直到总像元百分比小于或等于相似性阈值,或者选择绝对百分比差异最大的像元直到总像元百分比大于或等于差异阈值。
当选择按值时,将选择绝对百分比差异低于或等于相似性阈值或绝对百分比差异高于或等于差异阈值,并且两个模型之间的平均适宜性大于或等于高适宜性阈值的像元。
何时使用
此统计量与相似性与差异性统计量类似,只是将范围缩小到同时具有高适宜性的区域。 通过此统计量,您可以查看模型之间的相似之处和不同之处。 需要关注的是那些具有高适宜性但存在巨大差异的位置,因为这些区域表明模型之间存在严重分歧,如果最终区域落入这些区域可能会产生问题。
公式
此统计的公式为:
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability >= High_Suitability_Threshold), 1, Con((PercentDifference >= Difference_Threshold) & (MeanSuitability >= High_Suitability_Threshold), 2))
PercentDifference = Abs(Model1 - Model2) / Mean(Model1, Model2) * 100
MeanSuitability = Mean(Model1, Model2)
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Similarity_Threshold:将选择统计数据中值小于或等于阈值的像元。 所选像元是模型中被视为最相似的位置。默认值为小于或等于研究区域总像元中绝对百分比差异最小的 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
Difference_Threshold:将选择统计数据中值大于或等于阈值的像元。 所选像元是模型中被视为差异最大的位置。默认值为大于或等于研究区域中绝对百分比差异最大的 90% 的像元,即研究区域中绝对差异最高的前 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
High_Suitability_Threshold:适宜性值(高于该值表示位置被视为具有高适宜性),或研究区域中适宜性值最高的像元所占的百分比。默认值包括的像元大于或等于研究区域中适宜性值最高的 90% 像元,即研究区域中平均适宜性最高的前 10% 的像元。
如果选择按百分比像元,由于它表示像元的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 如果选择按值,则在模型已归一化时,范围将是两个适宜性地图之间的平均值的最小值和最大值,大约为 1 到 100,即归一化适宜性值的范围。 如果模型未归一化,则范围将为两个输入适宜性模型之间的平均值范围。
数据量:低适宜性模型的相似性
以下是低适宜性模型的相似性统计量的描述、使用时机及其公式。
描述
此统计量用于识别在两个模型之间具有相似性且具有低适宜性的位置。
当选择按百分比像元后,会选择具有最小百分比差异的像元,直到总像元百分比小于或等于相似性阈值,并且选择平均适宜性值最小的像元,直到达到低适宜性阈值。 当选择按值时,生成的地图将显示适宜性平均值,其中两个模型之间的绝对百分比差值低于或等于相似性阈值,适宜性平均值小于或等于低适宜性阈值。
何时使用
此统计量用于显示两个模型对于低适宜性区域的定位是否一致。 此统计量不仅用于确认模型间的高适宜性值是否一致,也用于确认模型间的低适宜性值是否一致。
公式
此统计的公式为:
Con((PercentDifference <= Similarity_Threshold) & (MeanSuitability <= Low_Suitability_Threshold), MeanSuitability)
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Similarity_Threshold:将选择统计数据中值小于或等于阈值的像元。 所选像元是模型中被视为最相似的位置。默认值为小于或等于研究区域总像元中绝对百分比差异最小的 10% 的像元。
如果选择按百分比像元,由于它表示像元总数的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 当选择按值时,范围将是适宜性地图之间的绝对百分比差异的最小值和最大值,无论是否选择标准化。 但是,两个范围可能会有所不同。
Low_Suitability_Threshold:适宜性值(低于该值表示位置被视为具有低适宜性),或研究区域中适宜性值最低的像元所占的百分比。如果选择按百分比像元,由于它表示像元的百分比,因此无论是否选择归一化选项,范围都将是从 1 到 100。 如果选择按值,则在模型已归一化时,范围将是两个适宜性地图之间的平均值的最小值和最大值,大约为 1 到 100,即归一化适宜性值的范围。 如果模型未归一化,则范围将为两个输入适宜性模型之间的平均值范围。
组 4:分析模型间的变化
分析模型间的变化功能组包含两项统计量:
统计量:适宜性值的空间关联
以下是适宜性值的空间关联统计量的描述、使用时机及其公式。
描述
此统计量用于确定某一区域的适宜性值与定义邻域内的适宜性值之间的相似性。
指定点数的值从两个适宜性地图中提取。 将对这些点执行双变量空间关联分析。 结果以栅格化图层的形式呈现,其分辨率与粗糙分辨率适宜性地图的分辨率保持一致。
两个适宜性地图之间的空间关联使用 Lee's L 统计。 输出分为五个空间关联类别:
高-高类别表示像元的显著性至少为 90%,两个模型的邻域加权平均值被视为高适宜性。
低-低类别表示像元的显著性至少为 90%,两个模型的邻域加权平均值被视为低适宜性。
低-高类别表示像元的显著性至少为 90%,第一个模型的邻域加权平均值被视为低适宜性,第二个模型被视为高适宜性。
高-低类别表示像元的显著性至少为 90%,第一个模型的邻域加权平均值被视为高适宜性,第二个模型被视为低适宜性。
不显著:表示两个模型之间的空间相关性不显著。
何时使用
此统计量是对检查模型间相似之处和不同之处的统计量的补充。 该统计量通过量化模型间高低值的对应关系,提供了更深层次的洞察。 如果模型间的高低值相互匹配,则无需担心。 出现高低值错位(即高-低或低-高)的位置是需要进一步分析的重点。
公式
此统计的公式为:
BivariateSpatialAssociation(Model1, Model2, Neighborhood_Type, Distance_Band_or_Number_of_Neighbors)
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Neighborhood_Type:指定如何确定每个点的相邻要素。 该点始终包含在邻域中,并且所有邻域权重被归一化为总和为 1。固定距离范围:每个点的指定临界距离内的点将被列为相邻要素。 这是默认设置。
K 最近邻:最近的 k 点将将被视为相邻要素而包括在分析中。
Distance_Band_or_Number_of_Neighbors:参数根据所选的相邻要素类型而变化。
Distance_Band:用于确定焦点周围相邻要素的距离带。 如果没有提供值,则该距离将是使得每个点在其邻域中具有至少一个相邻点的最短距离。
Number_of_Neighbors:识别将作为相邻要素包含的每个点周围的相邻要素数量。 该值不包括点。 例如,指定 6 将使用点及其六个最近的相邻要素(共七个点)。 默认值为 8。 该值必须至少为 2。
Percent Sampling of Suitability Map:确定从派生自适宜性地图的绝对百分比差异栅格获取以用于分析的点数。点数指定为适宜性地图中像元数的百分比。 通常,适宜性地图表现出高度的空间自相关性。 使用占研究区域像元总数 11% 的等距点(默认值),通常可以得到适宜性地图的最佳重采样表示。
百分比值通过按比例增加像元大小来确定重采样像元大小。 此重采样可减少将转换为点以用于分析的栅格像元的数量。 默认值 11% 对应的像元大小约为适宜性地图较粗分辨率的三倍。 较小的百分比会产生更少、间隔更宽的点,而较大的百分比会产生更多具有更精细空间细节的点。
分析中将使用的最大点数为一百万。
统计量:适宜性值变化(变化检测)
以下是**适宜性值变化(变化检测)**统计量的描述、使用时机及其公式。
描述
此统计量用于识别适宜性值从模型 1 到模型 2 的变化方式。
它计算两个适宜性地图之间的适宜性类别差异。 要为类别创建类,地图中的适宜性值使用等间距方法划分指定数量的类。 根据生成的适宜性类,统计数据可识别每个位置的适宜性类是否从模型 1 变为模型 2,如果类发生变化,则识别变为哪个类。
采用等间距方法创建类,以维持适宜性值的相对关系。
何时使用
此统计量用于量化适宜性值从一个模型到另一个模型的变化程度。 此统计量非常适用于测试假设场景。 在这些场景中,您可以探索更改子模型或条件之间的权重、条件变换或改变输入条件所产生的效果。 借助此统计量,您可以检查每次更改如何影响输出结果。
公式
此统计的公式为:
Combine([Reclass_model1, Reclass_model2])
Reclass_model1 = Slice( Model1, Number_of_Classes, slice_type="EQUAL_INTERVAL")
Reclass_model2 = Slice( Model2, Number_of_Classes, slice_type="EQUAL_INTERVAL")
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。Number_of_Classes:要将适宜性值重新分类(分组)以创建适宜性类别的类数。 两个选项是 3 和 5。 默认值为 3。
组 5:检查区域重叠的位置
检查区域重叠的位置功能组包含两项统计量:
统计量:区域重叠
以下是区域重叠统计量的描述、使用时机及其公式。
描述
此统计量用于识别结果区域之间的重叠区域和非重叠区域。
定义两个模型之间的区域重叠共有三种可能情况:
区域中的位置仅位于模型 1 中。
区域中的位置仅位于模型 2 中。
区域中的位置位于模型 1 和模型 2 中。
模型 1 和模型 2 中的区域位置用于识别模型一致的位置。 通常,重叠程度越高,表示模型之间的一致性程度越高。
何时使用
此统计量用于显示最终区域的相似之处和不同之处。 每当确定最终区域时,都可以使用此统计量来查看哪些位置被两个模型同时选中。 如果区域之间重叠很少,则说明模型间参数的更改显著改变了输出结果,表明这两个模型不可互换。
公式
此统计的公式为:
用于识别上方描述部分中三种情况的条件语句。
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。
统计量:适宜性等级的区域重叠
以下是适宜性等级的区域重叠统计量的描述、使用时机及其公式。
描述
此统计量用于识别结果区域重叠的位置、不重叠的位置以及属于某个区域的每个位置的适宜性级别。
定义两个模型之间的区域重叠共有九种可能情况:
该位置仅位于模型 1 的某个区域内,且适宜性高。
该位置仅位于模型 1 的某个区域内,且适宜性中等。
该位置仅位于模型 1 的某个区域内,且适宜性低。
该位置仅位于模型 2 的某个区域内,且适宜性高。
该位置仅位于模型 2 的某个区域内,且适宜性中等。
该位置仅位于模型 2 的某个区域内,且适宜性低。
该位置位于模型 1 和模型 2 的某个区域内,且适宜性高。
该位置位于模型 1 和模型 2 的某个区域内,且适宜性中等。
该位置位于模型 1 和模型 2 的某个区域内,且适宜性低。
如果某一位置仅位于模型 1 或模型 2 中,或位于模型 1 和模型 2 中,并且适宜性高,则通常无需担心该位置,因为该位置的适宜性仍为高。
应进一步调查仅属于模型 1 或模型 2 中的位置,或同时属于模型 1 和模型 2 中且适宜性属于中等或低水平的位置。
何时使用
此统计量为区域重叠统计量提供了更深层次的洞察。 如果重叠区域不多,请使用此统计量。 此统计量不仅能识别模型间最终区域重叠的位置和不重叠的位置,还能识别这些位置的适宜性值。 那些不重叠但在模型中属于高适宜性的区域可能无需担心。
公式
此统计的公式为:
使用 High_Suitability_Threshold 和 Medium_Suitability_Thresholds 参数识别上方描述部分的九种场景的条件语句。
其中:
Model 1:模型 1 的名称。Model 2:模型 2 的名称。High_Suitability_Threshold:确定被视为具有高适宜性值的像元。适宜性值大于或等于阈值的像元表示被视为具有高适宜性的位置,或者表示研究区域内具有最高适宜性的某个百分比的像元。
默认会选择平均适宜性值大于或等于研究区域中 90% 像元的像元,即研究区域内平均适宜性最高的前 10% 的像元。
Medium_Suitability_Threshold:确定被视为具有中等适宜性值的像元。适宜性值大于或等于中等适宜性阈值且小于高适宜性阈值的像元表示被视为具有中等适宜性的位置。 或者,在选出高适宜性像元之后,具有次高适宜性值的一定百分比的像元被分配中等适宜性。 适宜性值小于中等适宜性阈值的像元会被指定为低适宜性。
默认值为 80%,会选择平均值适宜性等于或大于 80% 但小于 90%(高适宜性阈值默认值)的像元,总计为研究区域的 10%。